
リチャード・サットンと強化学習:LLMの道に対する批判と強化学習の論述
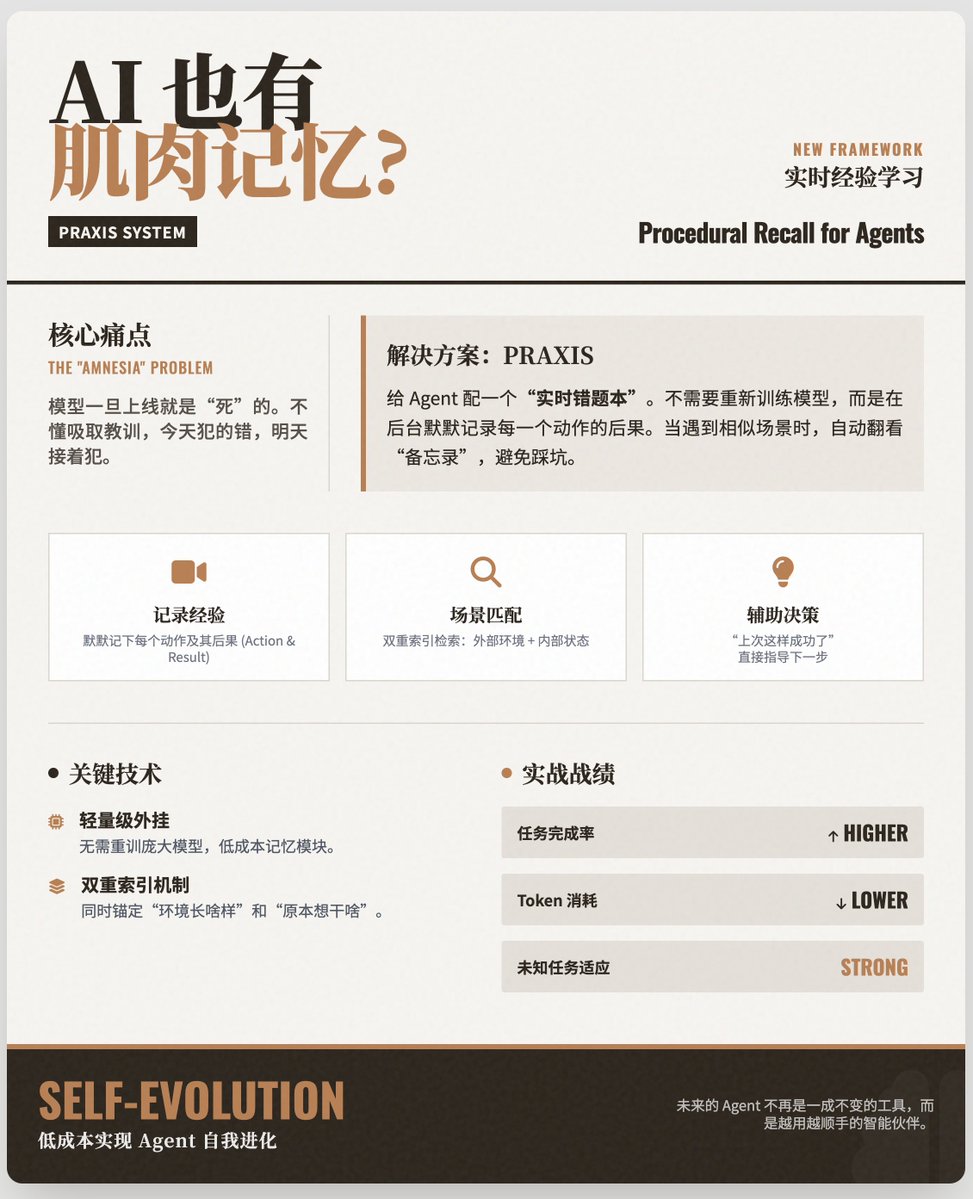
リチャード・サットンはLLMの限界を指摘し、強化学習に基づくエージェントの道を主張している。サットンは、LLMが次のトークンを予測することを目標としているため、明確な外部目標や行動能力が欠如しており、実際の経験から持続的に学ぶことができないと述べている。彼はジョン・マッカーシーなどの定義を引用し、知能は「目標を達成するための計算部分」であると強調している。また、サットンは強化学習の成功事例(TD-Gammon、AlphaZero、MuZero)を経験学習の証明として挙げている。生物学的視点から、リスなどの動物の学習メカニズムを理解することが汎用知能を理解する鍵であると考えられている。エージェントの展開後の「忘却症」を解決するために、PRAXIS(状態インデックス経験)メカニズムが提案され、リアルタイムの経験記録、シーンマッチング、意思決定支援を実現し、再訓練コストを低減し、ウェブタスクの完了率を向上させることが示されている。強化学習の核心概念(報酬、価値関数、時系列差分など)が主体と目標の重要性を論証するために使用されている。
Key insights
サットン:LLMは外部目標がなく、基盤となるAIの道ではない
リチャード・サットンは、大型言語モデルの訓練目標が次の単語(トークン)を予測することであるため、明確な外部目標や実行行動を持たず、強化学習エージェントのように試行錯誤を通じて実世界で持続的に学ぶことができないと指摘している。彼はマッカーシーによる「知能」の定義を引用し、目標と報酬信号が真のエージェントを構築する上での核心的な地位を強調している。
強化学習は持続可能な学習主体を構築する道である
サットンは、強化学習の主体—行動—観察—調整の循環が実環境で持続的に改善できることを強調し、TD-Gammon、AlphaZero、MuZeroなどの例を挙げて、経験駆動型のアプローチが模倣を超える性能を生み出すことを示している。これらの方法は、目標指向と経験学習を中心にしたスケーラビリティの利点を具現化している。
動物の学習から知能の基盤を探る提案
サットンは、リスなどの動物の学習メカニズムを理解することが人間の知能を理解する上で重要な参考価値を持つと提案し、自然界の試行錯誤と報酬メカニズムが汎用学習能力の基礎であると指摘している。一方、現在のLLMの方法は模倣に重きを置いており、経験に基づく探索学習ではない。
PRAXIS:エージェントが展開後に可視化可能な「筋肉記憶」を実現
展開後のエージェントが学習できない問題を解決するために、PRAXISはリアルタイムの経験記録と検索メカニズムを提案している。これにより、エージェントの行動と結果を記録し、外部シーンと内部状態を二重にインデックス化し、類似の状況に遭遇した際に検索して意思決定を支援する。実験では、ウェブブラウジングタスクにおいて完了率が大幅に向上し、コストが低減されることが示されている。