
ロボットAIのポストトレーニング標準化が求められる
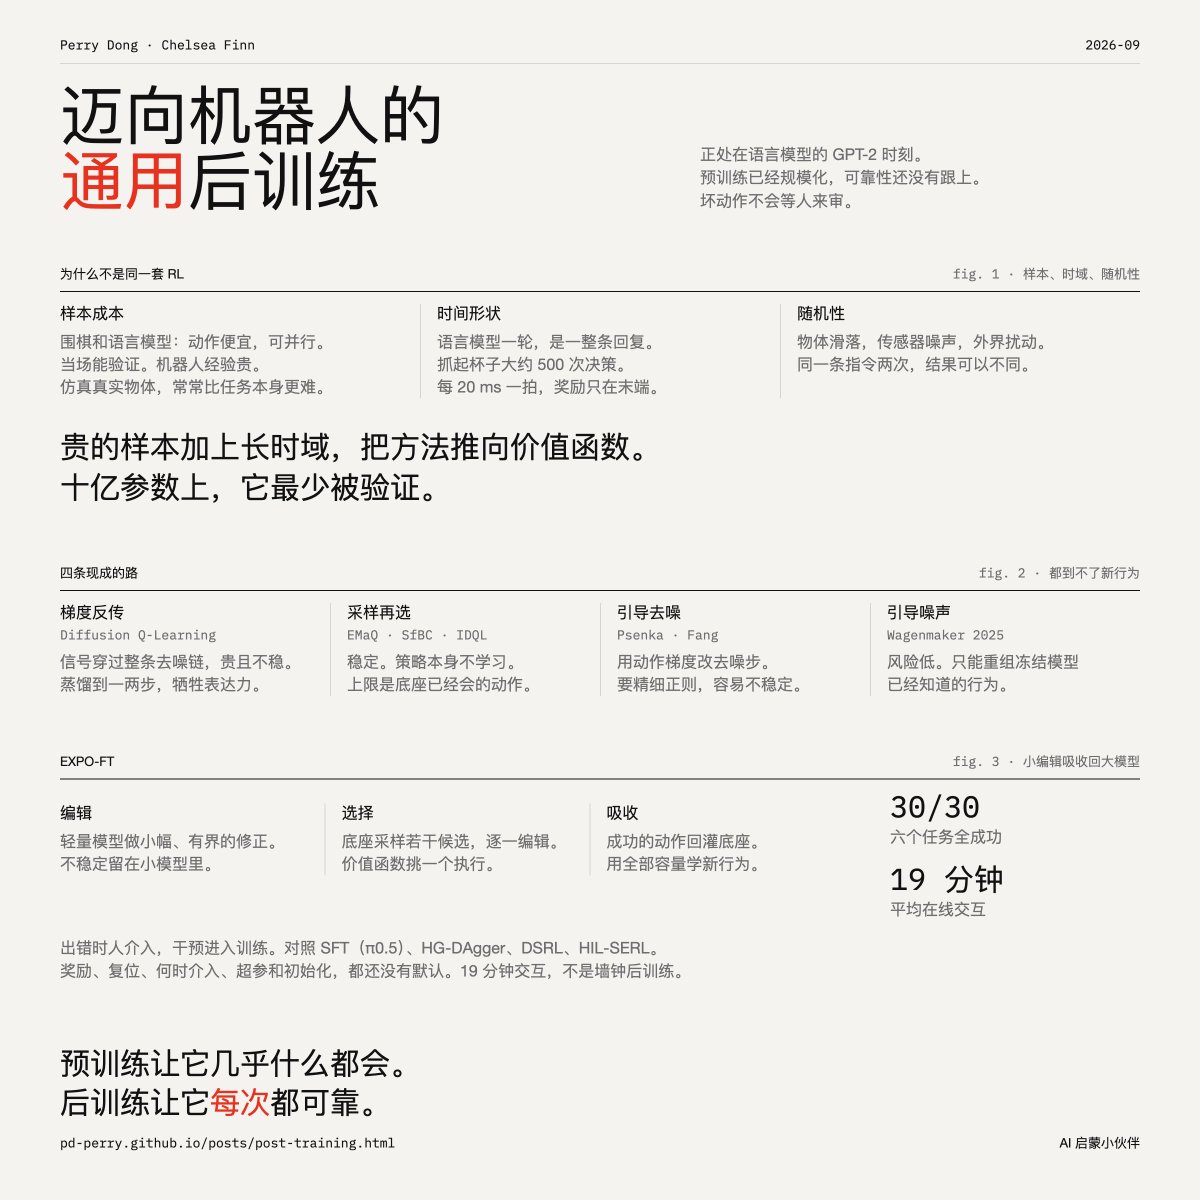
研究者らは、ロボットAIは「GPT-2の瞬間」にあると主張する。事前学習は拡大されているが、信頼性のための標準化されたポストトレーニングが欠けている。彼らは、小さな編集ポリシーと価値ベースのRLを組み合わせた手法EXPO-FTを提案し、わずか19分のオンラインインタラクションで6つの複雑な操作タスクにおいて完全な成功を達成した。
Key insights
ロボットAIは「GPT-2の瞬間」にある
ロボットAIの分野では事前学習(VLA、ワールドアクションモデル)が拡大され、広範だが信頼性に欠ける能力を提供している。欠けているのは、LLMの教師ありファインチューニング、RLHF、RLVRに類似した、標準化され再利用可能なポストトレーニングパイプラインである。著者らは、ロボット工学はさらに厳格な信頼性を必要とすると主張する。なぜなら、悪い動作は人間のレビューなしに即座に発生するからである。
ロボットRLとLLM RLの独自の課題
ロボットRLは根本的に異なる。サンプルコストが高く(実際のロボット経験は高価)、時間軸はタスクごとに数百の低レベル決定と疎な報酬を含み、物理やセンサーからの確率性がクレジット割り当てを複雑にする。これらの要因により、ロボット工学は価値ベースのRLへと向かうが、これは数十億パラメータ規模では最も検証が進んでいない。
EXPO-FT:候補となる解決策
EXPO-FTは3段階のメカニズムを使用する。軽量な編集ポリシーがベースモデルの出力に制限付きの修正を加え、価値関数が最適な行動を選択し、成功した行動は学習のためにベースモデルに吸収される。これにより、不安定性を小さなモデルに閉じ込めつつ、大きなモデルの能力を活用する。エラーが発生した場合には人間の監督が介入に使用される。
実験結果:複雑なタスクでの完全な成功
EXPO-FTは、6つの複雑な操作タスク(フックの糸通し、ビリヤードボールのポット入れ、卵の裏返しなど)において30/30の成功を達成し、平均わずか19分のオンラインインタラクションで実現した。これは、π0.5のSFT、HG-DAgger、DSRL、HIL-SERLなどのベースライン(平均成功数5.5~20.5)を大幅に上回った。
標準化のための未解決のプロトコル問題
著者らは、コミュニティの合意が必要ないくつかのプロトコル問題を特定している。報酬の指定方法(RLVR相当が存在しない)、リセットを誰が行うか、必要な人間のフィードバックの量、デフォルトのハイパーパラメータなどである。彼らは標準化されたパイプラインへの一歩として、EXPO-FTのチューニングリファレンスを公開した。
既存手法が失敗する理由
本論文は「除外のマップ」を提供する。拡散Q学習は高コストで不安定、サンプリング後選択法はポリシーを改善しない、行動勾配ガイダンスは細かい正則化を必要とする、入力ノイズ空間ガイダンスは既知の行動を再結合するだけである。古典的な価値ベースのRLは単峰性ガウス分布ポリシーを仮定するが、最先端モデルは多峰性拡散/フロー生成を使用する。