
ロボティクス、LLMのGPT-2の瞬間:標準化されたポストトレーニングの必要性
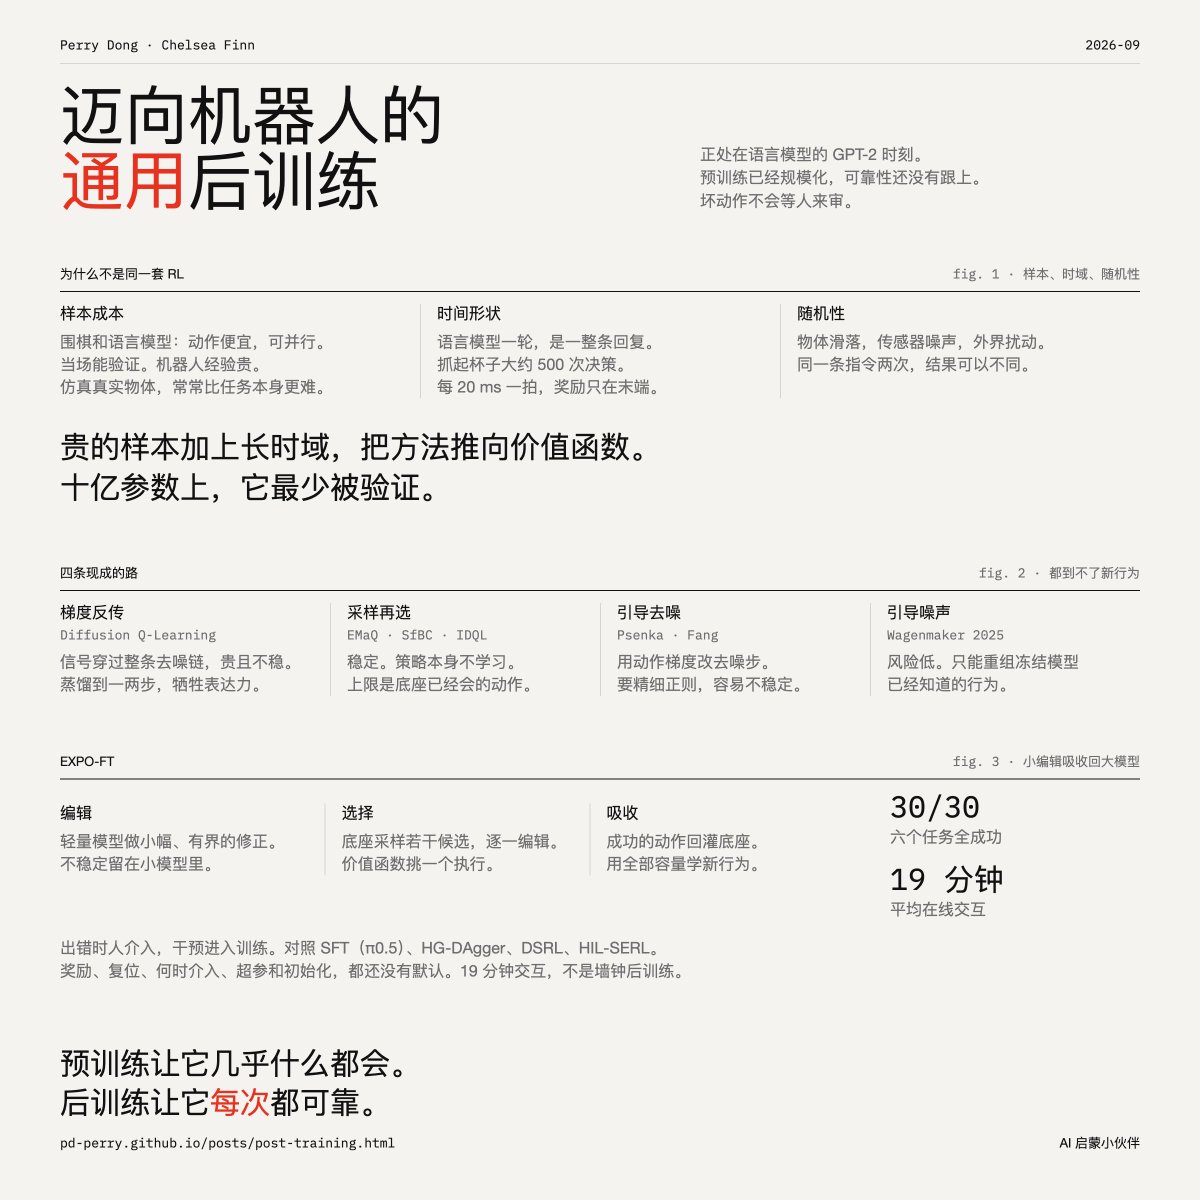
研究者らは、ロボティクス向けの標準化されたポストトレーニング手法であるEXPO-FTを提案し、大規模な事前学習後の信頼性の高い性能の必要性に応えた。6つの複雑なタスクにおいて、EXPO-FTは平均19分のオンラインインタラクションで30/30の成功を達成し、SFTやHG-DAggerなどのベースラインを上回った。
Key insights
ロボティクスのポストトレーニングには標準化が不足
ロボティクス分野は「GPT-2の瞬間」にあり、事前学習モデル(VLA、世界行動モデル)は広範だが不安定な能力を持つ。欠けているのは、「できる」を「毎回確実に行う」に変換するための標準化され再利用可能なポストトレーニングパイプラインである。著者らは、LLMの教師ありファインチューニング、RLHF、RLVRの経路との類似性を指摘するが、ロボティクスは単一の悪い行動が人間のレビューなしに即座に発生するため、より厳格な信頼性要件があると述べている。
ロボティクスRLとLLM RLの主な違い
ロボティクスRLはLLM RLと3つの重要な点で異なる:サンプルコスト(ロボットの経験は高価でシミュレーションは困難)、時間的構造(エピソードあたり数百から数千の低レベル決定と疎な報酬)、および確率性(物体の滑り、センサーノイズ)。これらの要因により、ロボティクスは価値ベースRLへと向かうが、これは数十億パラメータ規模で最も検証が進んでいない。論文はこれを解決すべき核心的な矛盾と特定している。
既存手法は異なる理由で失敗
著者らは、現在のアプローチが不十分な理由の「除外マップ」を提示している:拡散Q学習は長いデノイジングチェーンに悩まされる;サンプリング後選択手法(EMaQ、SfBC)はベースモデルの提案能力で性能が頭打ちになる;行動勾配誘導型デノイジングは繊細な正則化を必要とする;入力ノイズ空間ガイダンスは既知の行動を再結合するだけである。古典的な価値ベースRLはガウス型単峰性方策を仮定するが、最先端モデルは多峰性行動に拡散を使用し、ブートストラップ誤差がスケールで増幅される。
EXPO-FT:小モデルと大モデルの分割による3段階ソリューション
EXPO-FTは軽量な「編集方策」を使用してベースモデルの出力に制限付き修正を加え、行動を価値のピークに向かわせる。実行中、ロボットは候補行動をサンプリングし、編集し、価値関数を介して最良のものを選択する。成功した行動はトレーニングを通じて事前学習モデルに吸収され、大規模モデルがノイズ空間の再結合を超えた新しい行動を学習できるようにする。人間の監視は介入に使用され、Waymoの遠隔安全オペレーターと同様である。
実験結果は複雑なタスクで30/30の成功を示す
EXPO-FTは6つの複雑な操作タスクでテストされた:フックにライトを通して差し込む、ビリヤードボールをポットに入れる、花をボトルネックに挿入する、卵をひっくり返す、ボールのバランスを取る。全タスクで30/30の成功を達成し、平均オンラインインタラクション時間はわずか19分であった。これは、π0.5上のSFT、HG-DAgger、DSRL、HIL-SERLなどのベースライン(平均5.5~20.5の成功)を大幅に上回った。
普遍的な採用には未解決のプロトコル問題が残る
論文のタイトルには「Universal」が含まれているが、コミュニティで解決すべきいくつかのプロトコル問題がある:報酬の指定方法(ロボティクスにはRLVR相当がなく、学習された成功分類器が有望)、リセットを誰が行うか(学習されたリセット戦略または可逆的なタスク設計)、どの程度の人間の介入が必要でいつ行うか、デフォルトのハイパーパラメータ、初期化データの重み付け方法。著者らは標準化への一歩としてEXPO-FTチューニングリファレンスを公開している。