
ロボティクスの「GPT-2の瞬間」:EXPO-FTによる普遍的なポストトレーニング手法
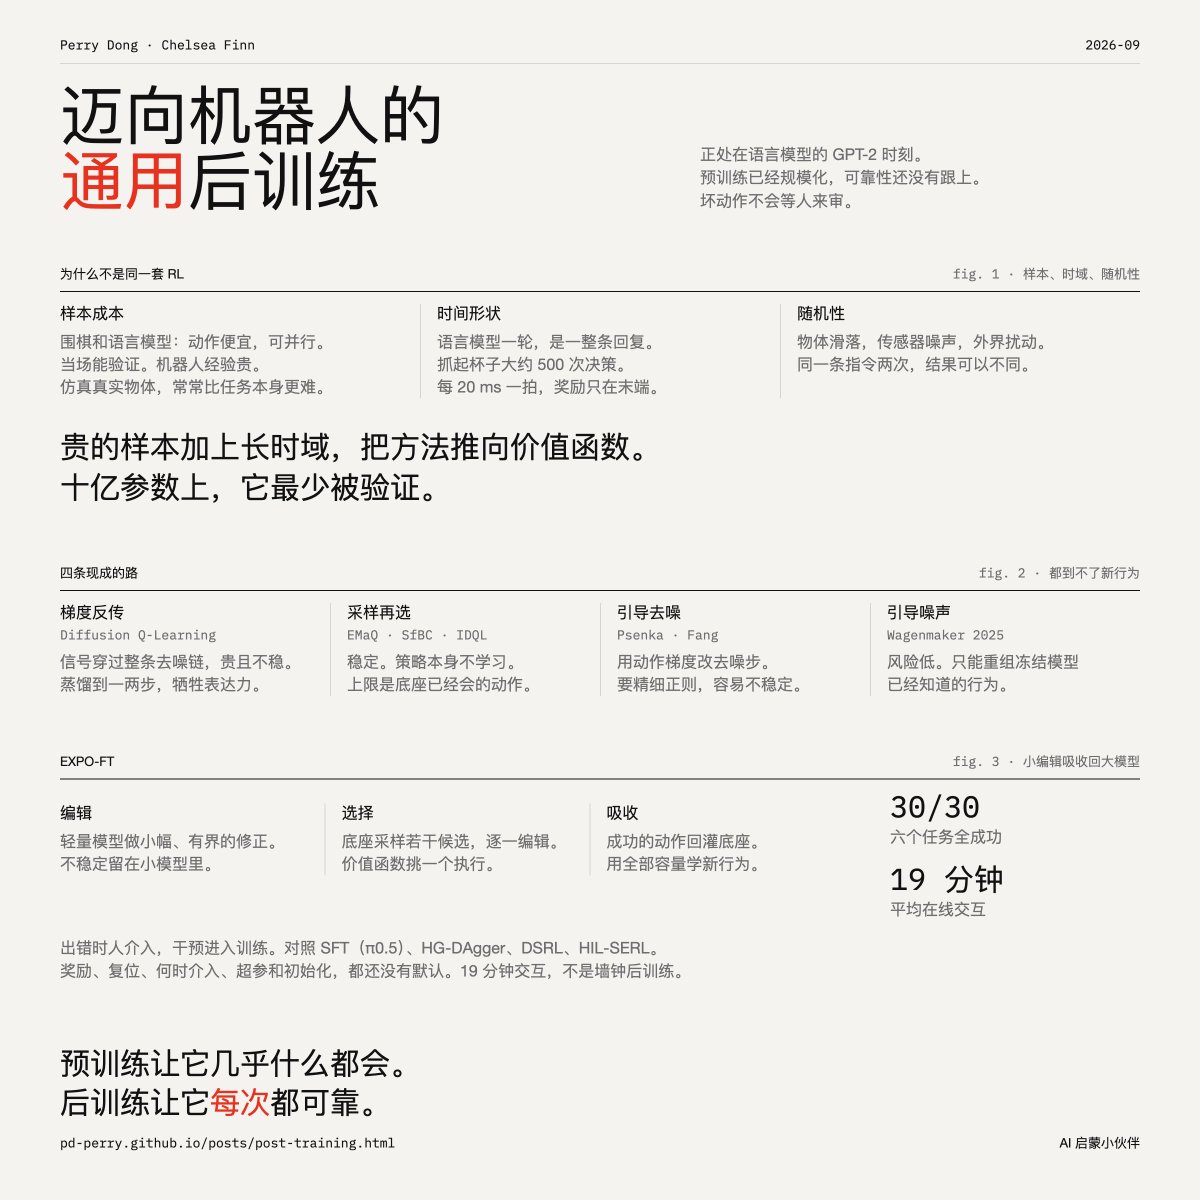
研究者らは、ロボット強化学習のための普遍的なポストトレーニング手法であるEXPO-FTを発表した。この手法は、編集ポリシー、実行選択、吸収を用いて大規模基盤モデルを安定化させる。6つの複雑な操作タスクにおいて、わずか19分間のオンラインインタラクションで30/30の成功率を達成し、ベースラインを大幅に上回った。
Key insights
ロボティクス、GPT-2の瞬間に立つ
ロボティクス分野は、LLMの「GPT-2の瞬間」と比較されている。事前学習されたVLA(視覚言語行動)モデルや世界行動モデルはスケーラブルだが信頼性に欠ける。不足しているのは、不確かな能力を信頼性の高いパフォーマンスに変換するための標準化されたポストトレーニング手法である。EXPO-FTは、言語モデルにおける教師ありファインチューニングやRLHFと同様のレシピを提供することを目指している。
ロボットRLとLLM RLの課題の違い
ロボットRLはLLM RLと3つの点で異なる。物理実験は高コストであるためサンプルコストが高い。時間軸が長く、低レベルのステップが数百回必要で報酬は疎である。環境の確率的性質(例:滑り)がクレジット割り当てを乱す。これらの要因により、ロボティクスは価値ベースRLへと向かうが、これは数十億パラメータ規模では最も検証が進んでいない。
EXPO-FTの中核メカニズム
EXPO-FTは3つの段階から成る。1) 編集ポリシー(軽量モデル)がベースモデルからの候補行動に範囲制限付きの修正を加え、そのモード内でより高い価値に向けてシフトさせる。2) 実行時には、複数の候補行動がサンプリングされ、編集され、価値関数によって最良のものが選択される。3) 成功した行動は事前学習モデルに吸収され、改善を内面化するための訓練に使用される。
ヒューマン・イン・ザ・ループによる監督
人間が監督者として機能する。ロボットが誤った場合、人間が介入し、介入データが訓練ループに入る。著者らはこれを、スケーラビリティのためのWaymoの遠隔安全オペレーターに例えている。これにより、システムの安全性を保ちつつ、実世界での修正から継続的な改善が可能となる。
実験結果
EXPO-FTは、6つの複雑なタスク(例:軽いガーランドを通す、花を鉢に植える、卵をひっくり返す)において、平均19分のオンラインインタラクションで30/30の成功率を達成した。ベースライン手法(π0.5でのSFT、HG-DAgger、DSRL、HIL-SERL)は平均成功率5.5~20.5であった。
未解決のプロトコル課題
EXPO-FTが普遍的なレシピとなるためには、コミュニティが報酬の仕様(ロボット向けのRLVRに相当するものはない)、リセット戦略、人間の介入様式、ハイパーパラメータのデフォルト値、初期化データの重み付けについて合意する必要がある。著者らは最初のステップとしてチューニング推奨事項を公開している。
既存手法が失敗する理由
論文は代替手法を系統的に排除している。拡散Q学習はコストが高く不安定。EMaQはポリシーをベースモデルの提案に制限する。行動勾配ガイダンスは繊細な正則化を必要とする。ノイズ空間ガイダンスは凍結された行動を再結合するだけである。古典的な価値ベースRLは単峰性ポリシーを仮定しており、拡散モデルの多峰性行動と互換性がない。