
ロボティクスのポストトレーニングが「GPT-2の瞬間」を迎える
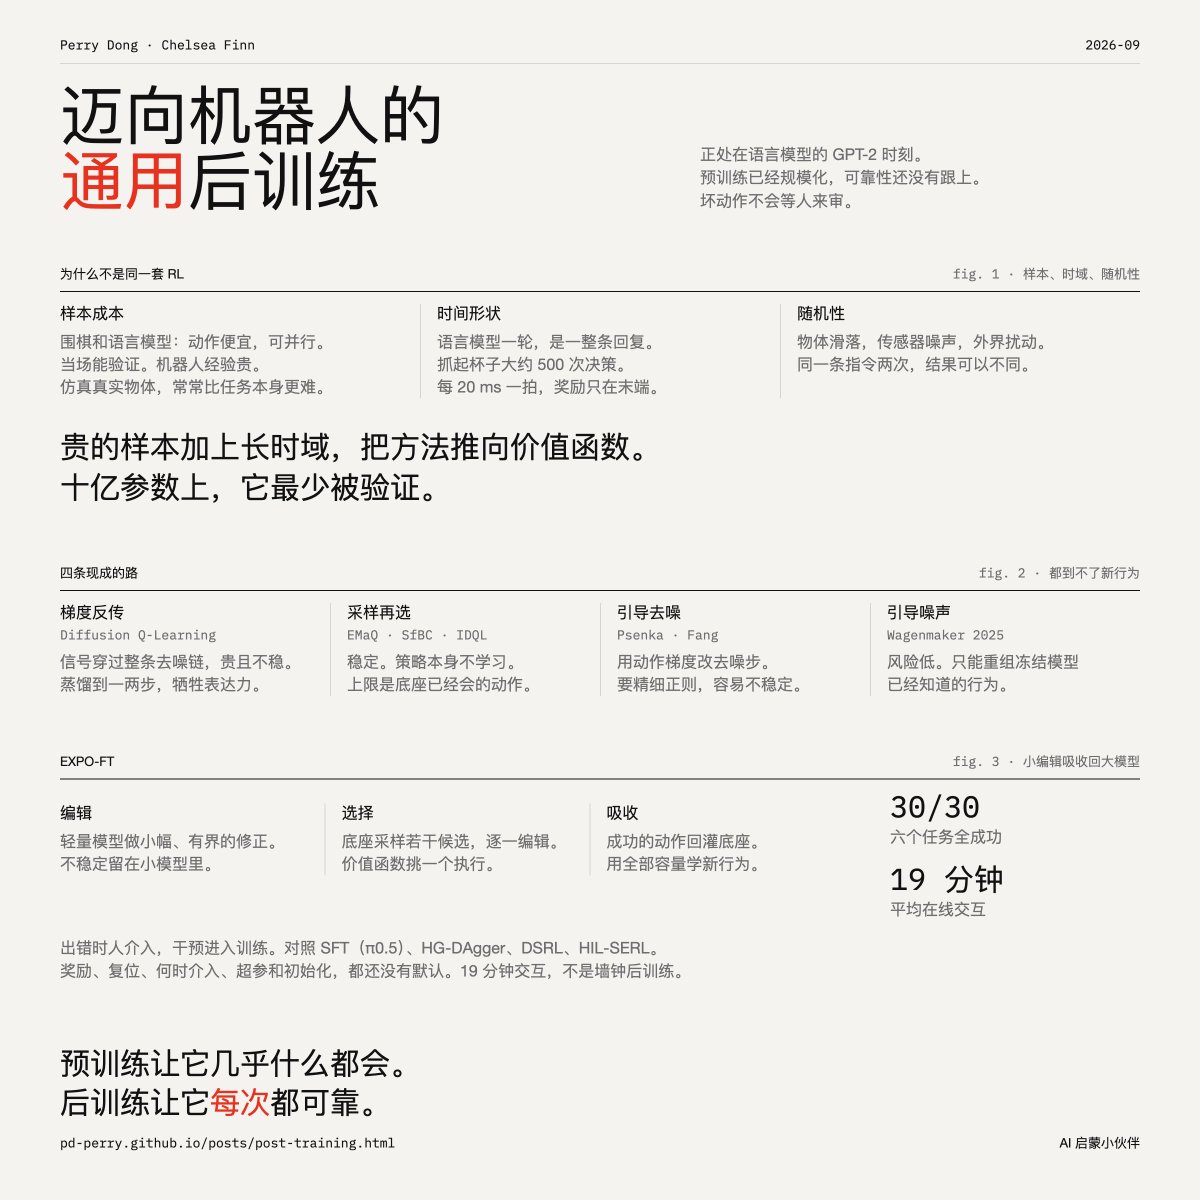
研究者らは、ロボティクスのポストトレーニングは、大規模言語モデル(LLM)がGPT-2で経験したのと同様の転換点にあり、広範な能力を信頼性の高いパフォーマンスに変換するための標準化された手法が必要だと論じている。彼らは、大規模な事前学習モデルからの行動を小さな編集ポリシーで洗練する価値ベースの強化学習手法であるEXPO-FTを提案し、複雑なタスクにおいて最小限のオンラインインタラクションで30/30の成功率を達成した。
Key insights
ロボティクスにおけるGPT-2の瞬間の類推
著者らは、ロボティクスのポストトレーニングはLLMにおける「GPT-2の瞬間」にあると述べている。すなわち、事前学習されたVLA(ビジョン・言語・行動)モデルやワールドアクションモデルは広範だが信頼性の低いスキルを持つ。欠けているのは、「できる」を「確実に実行する」に変換するための標準化された再利用可能なポストトレーニングパイプラインである。LLMは教師ありファインチューニングからRLHF(人間のフィードバックからの強化学習)、RLVR(検証可能な報酬による強化学習)へと進化した経路をたどり、ロボティクスにも同等のものが必要である。
ロボット強化学習に固有の課題
ロボットの強化学習はLLMの強化学習と3つの点で異なる。サンプルコスト(ロボットの経験は高価であり、シミュレーションがタスク自体よりも難しい場合がある)、時間的形状(エピソードあたり数百から数千の低レベル決定を疎な報酬で行う)、および確率的要素(物体の滑り、センサノイズ)である。これらの要因により、ロボティクスは価値ベースの強化学習へと向かうが、そのような手法は十億パラメータ規模では最も検証が進んでいない。
既存手法の限界
論文では、現在の手法が失敗する理由を明らかにしている。拡散Q学習は高コストで不安定、サンプリングベースの手法(EMaQ、SfBC)はベースモデルに制限される、行動勾配法は注意深い正則化を必要とする、入力ノイズ空間ガイダンスは既知の行動を再結合するだけである。古典的な価値ベースの強化学習はガウス分布の単峰性ポリシーを前提とするが、現代のモデルは多峰性行動のために拡散やフローを使用する。
EXPO-FTのメカニズムと設計
EXPO-FTは3段階のプロセスを使用する。(1)軽量な編集ポリシーがベースモデルからの候補行動に有界な修正を加え、価値のピークに向けて押し上げる。(2)ロボットは複数の候補をサンプリングし、それらを編集し、価値関数を介して最良のものを選択する。(3)成功した行動は継続学習により事前学習モデルに吸収される。強化学習の不安定性は小さな編集ポリシーに限定される。
実験結果と人間参加型
EXPO-FTは6つの複雑な操作タスク(例えば、フックに糸を通す、ボールをポットに入れる、卵をひっくり返す)において、平均19分のオンラインインタラクションで30/30の成功率を達成した。SFT、HG-DAgger、DSRL、HIL-SERLなどのベースラインを上回った。人間の役割は遠隔の安全監視員であり、エラーに介入し、そのデータをトレーニングに使用する。これはWaymoの遠隔安全オペレーターに類似している。
標準化に向けた未解決のプロトコル問題
論文は、コミュニティの合意が必要な未解決の問題を特定している。報酬の指定(ロボティクスにRLVR相当のものがない)、リセット戦略、人間の介入タイミング、ハイパーパラメータのデフォルト値、初期化データの重み付けなどである。著者らは、標準化されたパイプラインへの一歩として、EXPO-FTのチューニングリファレンスを公開した。