
推論プロバイダー、共有GPU容量で速度とコストのトレードオフに直面
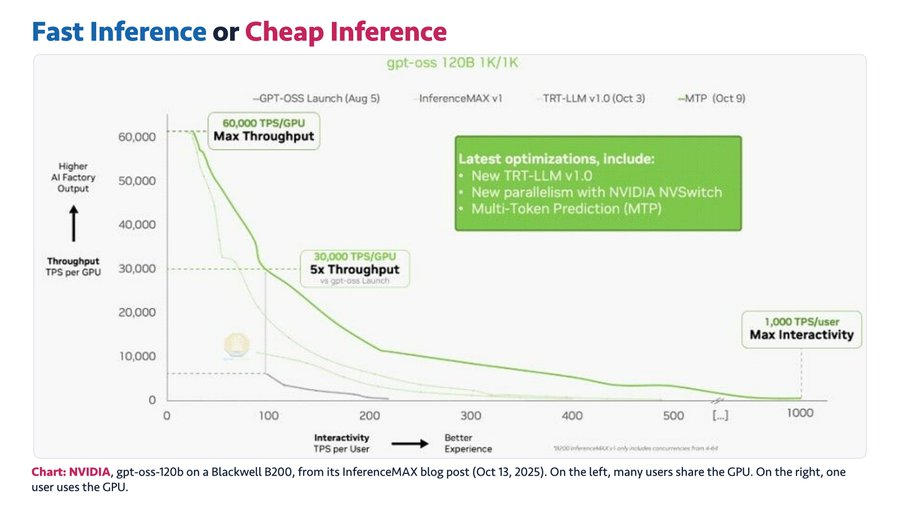
推論プロバイダーは、ユーザーをGPUにどのように割り当てるかによって速度とコストの両方が決まるため、二者択一のトレードオフに直面している。GroqとCerebrasは速度を優先する一方、CoreWeave、Novita、Crusoeは低価格に傾いている。1台のBlackwell GPUを1人のユーザーに提供すると約1,000トークン/秒を実現するが、複数ユーザーで共有すると総スループットは60,000トークン/秒に向上するものの、各ユーザーは約20~100トークン/秒に低下する。
イベントのバージョン 1.
Key insights
速度追求はアイドル容量を必要とする
速度を追求することは、GPUあたりのユーザー数を減らすことを意味し、より多くのアイドル計算資源を残してトークンコストを上昇させる。
プロバイダーは優先順位で分かれる
GroqとCerebrasは速度を選び、CoreWeave、Novita、Crusoeは低価格に傾いている。
単一ユーザーのスループットは限定的
1台のBlackwell GPUを1人のユーザーに提供すると約1,000トークン/秒を実現し、カード全体でも同じ1,000トークン/秒しか生成しない。
共有は総量を増やすがユーザーあたりの速度を下げる
複数ユーザーがGPUを共有すると、総スループットは60,000トークン/秒まで上昇する可能性があるが、各ユーザーは約20~100トークン/秒しか受け取れない。
トレードオフはリソース割り当ての問題
速度とコストは根本的に同じGPU上のリソース割り当ての問題である。