
谷歌 TPUv7 が NVIDIA Blackwell に対抗する深層分析
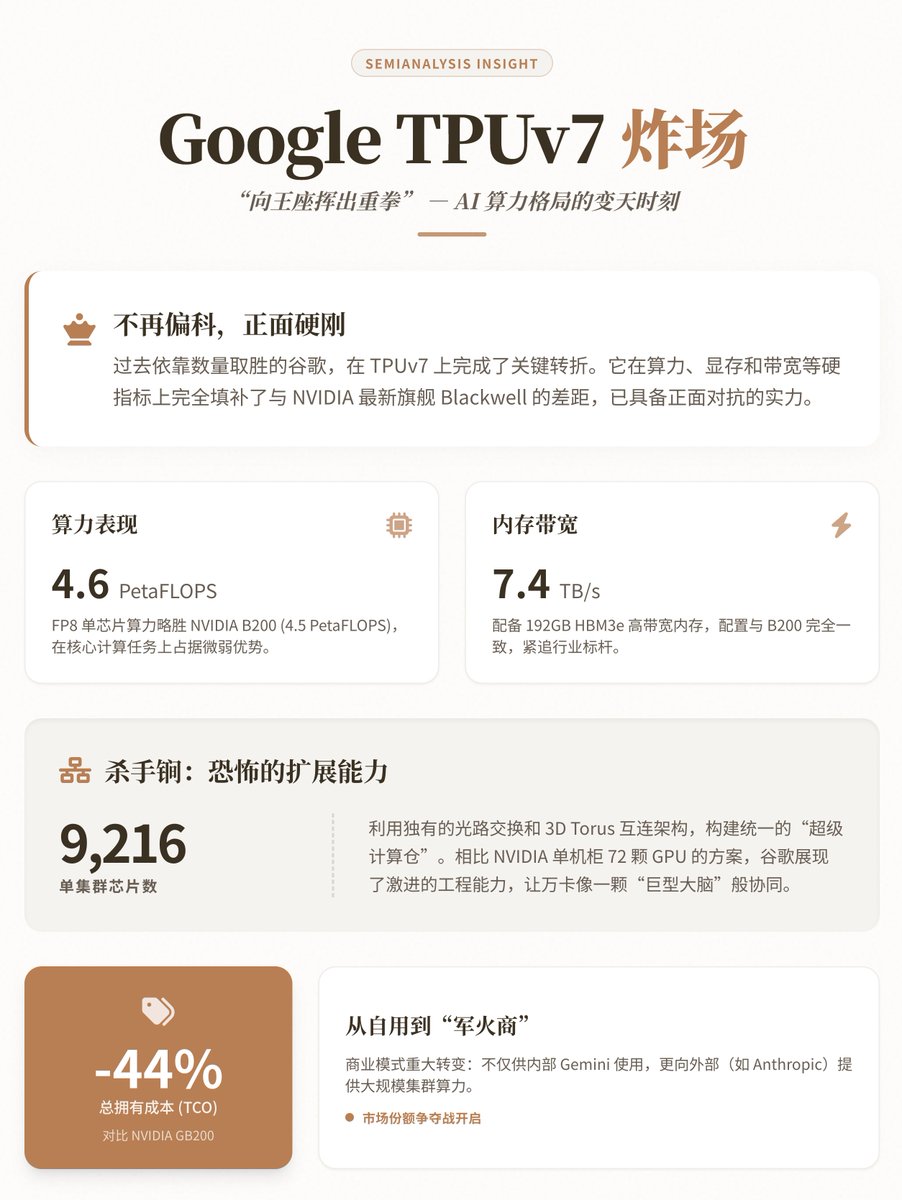
谷歌 TPUv7(コード名 Ironwood)は、性能、メモリ、インターコネクトにおいて NVIDIA Blackwell(B200)に追いつき、またはそれを超え、顕著な拡張性とコスト優位性を持っています。
Key insights
TPUv7 の単一チップ算力は Blackwell に追いつくか、わずかに超える
報告書では、TPUv7 の単一チップ FP8 算力が約 4.6 PetaFLOPS であり、NVIDIA B200 の 4.5 PetaFLOPS をわずかに上回っていることが示されています。TPUv7 は 192GB HBM3e を搭載し、帯域幅は 7.4 TB/s に達し、仕様は B200 とほぼ同等です。文中では、主要なハードウェアパラメータを比較し、一般的なトレーニングおよび推論計算において TPUv7 が Blackwell と同じレベルにあることが指摘されています。
TPUv7 の拡張インターコネクトは核心的競争力
記事では、TPUv7 の最大の利点は拡張能力にあると指摘されています。谷歌は光路交換技術と 3D Torus インターコネクトを通じて、最大 9,216 個の TPUv7 チップを単一のスーパー集群に接続でき、これによりトリリオンパラメータモデルのトレーニング時に通信ボトルネックを大幅に軽減します。比較として、NVIDIA の一般的な GB200 NVL72 システムは単一マシンで 72 GPU を使用しますが、キャビネット間での拡張は可能であるものの、単一の大規模集群構築において谷歌とは異なります。
谷歌の垂直統合がもたらす顕著な TCO 優位性
SemiAnalysis の推計によれば、谷歌がチップ設計、データセンター、冷却、ネットワークなどのエンドツーエンドの能力を掌握しているため、TPUv7 システムの総所有コストは NVIDIA GB200 サーバーソリューションを購入するよりも約 44% 低く、広範な算力を必要とする顧客にとって価格的魅力があります。これにより、調達選択が変わる可能性があります。
谷歌のビジネスモデルが内部使用から外部販売へと変化
記事では、TPU が過去に主に谷歌内部で使用されていたこと、外部顧客はクラウドを通じてレンタルしていたことが指摘されています。現在、谷歌は外部に対してより柔軟な算力サービスを提供し、Anthropic のような顧客を引き付けています。Anthropic は大規模 TPU 集群の購入と使用を約束しており、谷歌が「算力供給者」として市場で NVIDIA と競争し始めていることを示しています。
CUDA の護城河はエンジニアリング能力とオープンソースエコシステムによって挑戦されている
別のユーザーコメントでは、英偉達の CUDA 護城河は堅固ではなく、優れたエンジニアはソフトウェア(例:Triton)やシステム調整を通じて既存の実装を超えることができると指摘されています。歴史的に、多くのモデルは GPU でのみトレーニングされるわけではなく、Anthropic や他の企業は長期間 TPU を使用しており、ハードウェア効率の差は限られており、重要なのはカーネルとシステムエンジニアリングの人材です。