
谷歌 TPUv7 と英偉達の競争(AI チップと計算力の構図)
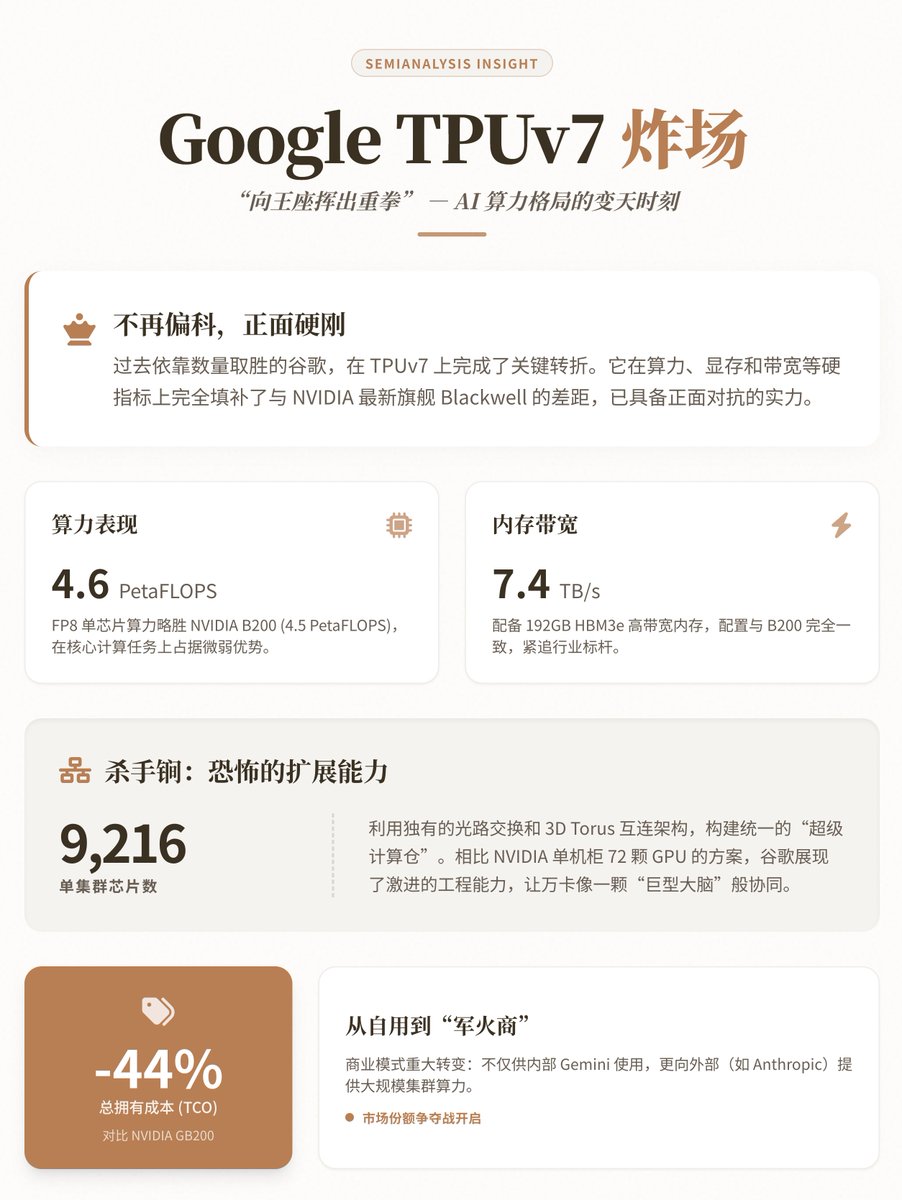
SemiAnalysis の報告によると、TPUv7(Ironwood)はハード指標において NVIDIA Blackwell シリーズと同等のレベルに達しており、クラスターの拡張性とコスト面で優位性を持っています。 • TPUv7 の単一チップ FP8 計算力は約 4.6 PetaFLOPS で、NVIDIA B200 の 4.5 PFLOPS をわずかに上回っています。 • TPUv7 は 192GB HBM3e を搭載し、メモリ帯域幅は 7.4 TB/s に達します。 • 谷歌は光路交換と 3D Torus インターコネクトを利用し、9,216 個のチップを接続して超大規模クラスターを構築できます。 • 総保有コスト(TCO)は NVIDIA のソリューションより約 44% 低いと推定されています。 • 谷歌は「自社利用」から外部への計算力提供に転換しており、Anthropic などの大手顧客が TPU クラスターの使用を約束しています。 • コミュニティの声では、TPU と GPU の競争力はエンジニアの実装によって影響を受けるとされており、優れたエンジニアが効率に大きな影響を与える可能性があります。
Key insights
TPUv7 は単一チップのハード指標で NVIDIA を追い越すか同等に
分析によると、TPUv7 の単一チップ FP8 計算力は約 4.6 PFLOPS で、192GB HBM3e を搭載し、7.4 TB/s の帯域幅を持ち、ハード指標は NVIDIA B200 と同等です。この性能は、トレーニングや推論に一般的に使用されるタスクに対して直接的な競争を構成し、谷歌がチップ設計において顕著な進展を遂げていることを示しています。
谷歌は大規模な相互接続とクラスター拡張において独自のエンジニアリング優位性を持つ
TPUv7 の重要な競争力は拡張能力にあります。谷歌は光路交換と 3D Torus インターコネクト設計を通じて、9,216 個のチップを統一されたスーパークラスターとして構築でき、通信ボトルネックを減少させ、万億パラメータ級モデルのトレーニングに適しています。NVIDIA のラックマウント接続と比較して、谷歌のクラスターのエンジニアリングパスは異なり、スケールの利点があります。
コストと商業化の変化が市場構造を変える可能性
SemiAnalysis の推定によると、谷歌の垂直統合に基づき、TPUv7 システムの総保有コストは NVIDIA サーバーより約 44% 低いとされています。谷歌は内部利用から外部への計算力提供に転換しており、Anthropic を含む大手顧客を引き寄せており、これは市場競争の構図が「単一供給」からより激しい二雄または多者競争へと移行する可能性を示唆しています。
コミュニティの見解:護城河はシステムエンジニアリング能力に依存する
エンジニアコミュニティは、TPU と GPU の差は克服不可能ではなく、効率の改善とコア/システムエンジニアリングの人材が運用効率を大きく変える可能性があると指摘しています。したがって、単にハードウェアに依存することは絶対的な護城河ではなく、優れたエンジニアが異なるハードウェアプラットフォームを効率的に調整できることが重要です。