
谷歌の論文:トレーニング後の継続的学習とネストされた記憶
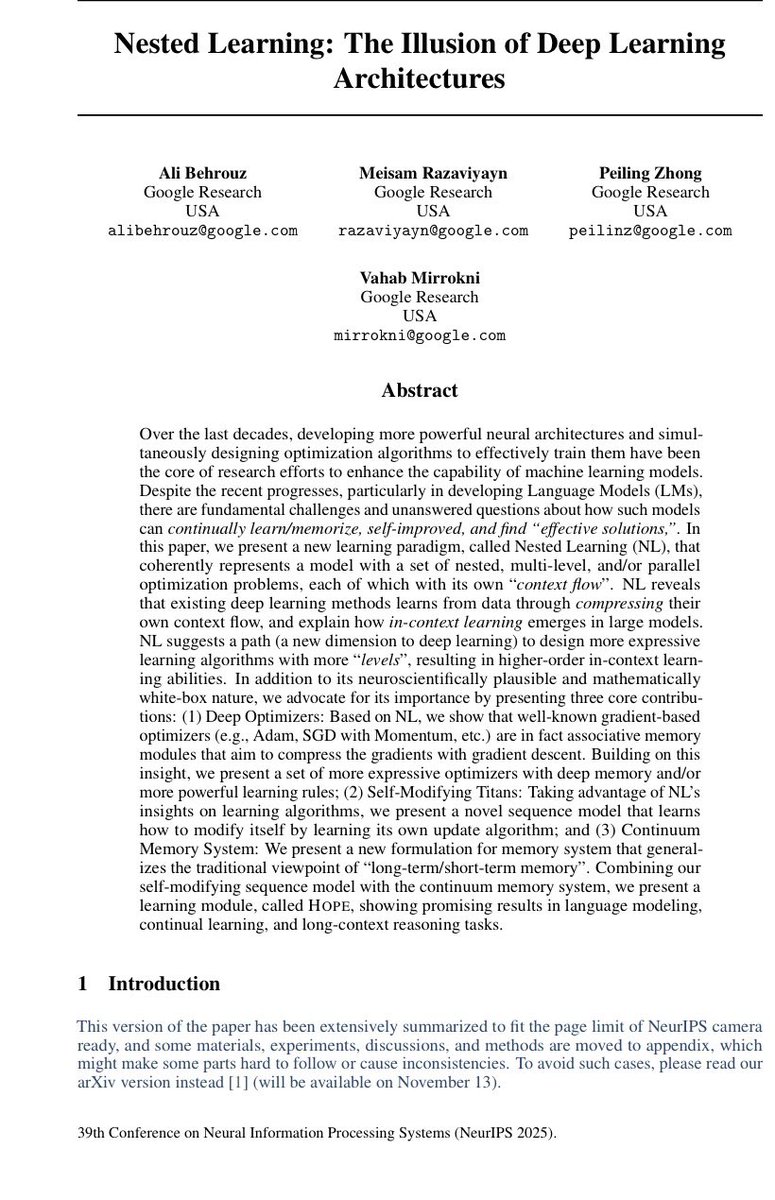
谷歌の研究は、LLMがトレーニング後に持続的に学習できない問題とその解決策を提案し、記憶を「速い/遅い」の二分法から連続的な時間と更新のスペクトル(ネストされた学習)に拡張することを推奨しています。- 論文は、既存のモデルが「トレーニング後に学習を継続できない」という共通の問題(デジタル失念症)を抱えていることを指摘しています。- 「ネストされた学習」という概念を提案し、迅速な記憶と遅延した記憶の間に連続的なスペクトル(異なる時間スケールの記憶階層)を構築します。- 論文は、トレーニングのパラダイムを変更する際には、規模だけでなく、時間と更新頻度も考慮する必要があると述べています。- 著者とコメント者は、これがAIの使用過程における持続的な改善の方法を効果的に変える可能性があると考えています。
Key insights
問題の認識:トレーニング後に継続的に学習できない
谷歌の論文は、現在のLLMが現在の対話と事前トレーニングデータにアクセスできる一方で、新しい情報を体系的かつ持続的に長期記憶に統合できないことを指摘しています。研究者はこれを「デジタル失念症」と呼び、AIの使用中に持続的に改善する上での重要な問題と見なしています。
提案された解決策:ネストされた学習の記憶スペクトル
論文は「ネストされた学習」プランを提案し、短期記憶と長期記憶の二分法を置き換えるために、連続的な記憶スペクトル(速い—中間—遅いの複数の時間スケール)を構築することで、モデルが異なる頻度で情報を学習し固定できるようにし、人間の脳の記憶の勾配曲線に似たものとしています。
方法論的な新しい次元:時間スケールの考慮
論文は、AI設計において時間と更新頻度を規模と同等に重要な次元として考慮すべきであると強調しています。これは、モデルがより大きく、より深いだけでなく、異なる速度で持続的に新しい情報を吸収し安定させるメカニズムを備える必要があることを意味します。