
長文脈エージェント向けメモリシステム
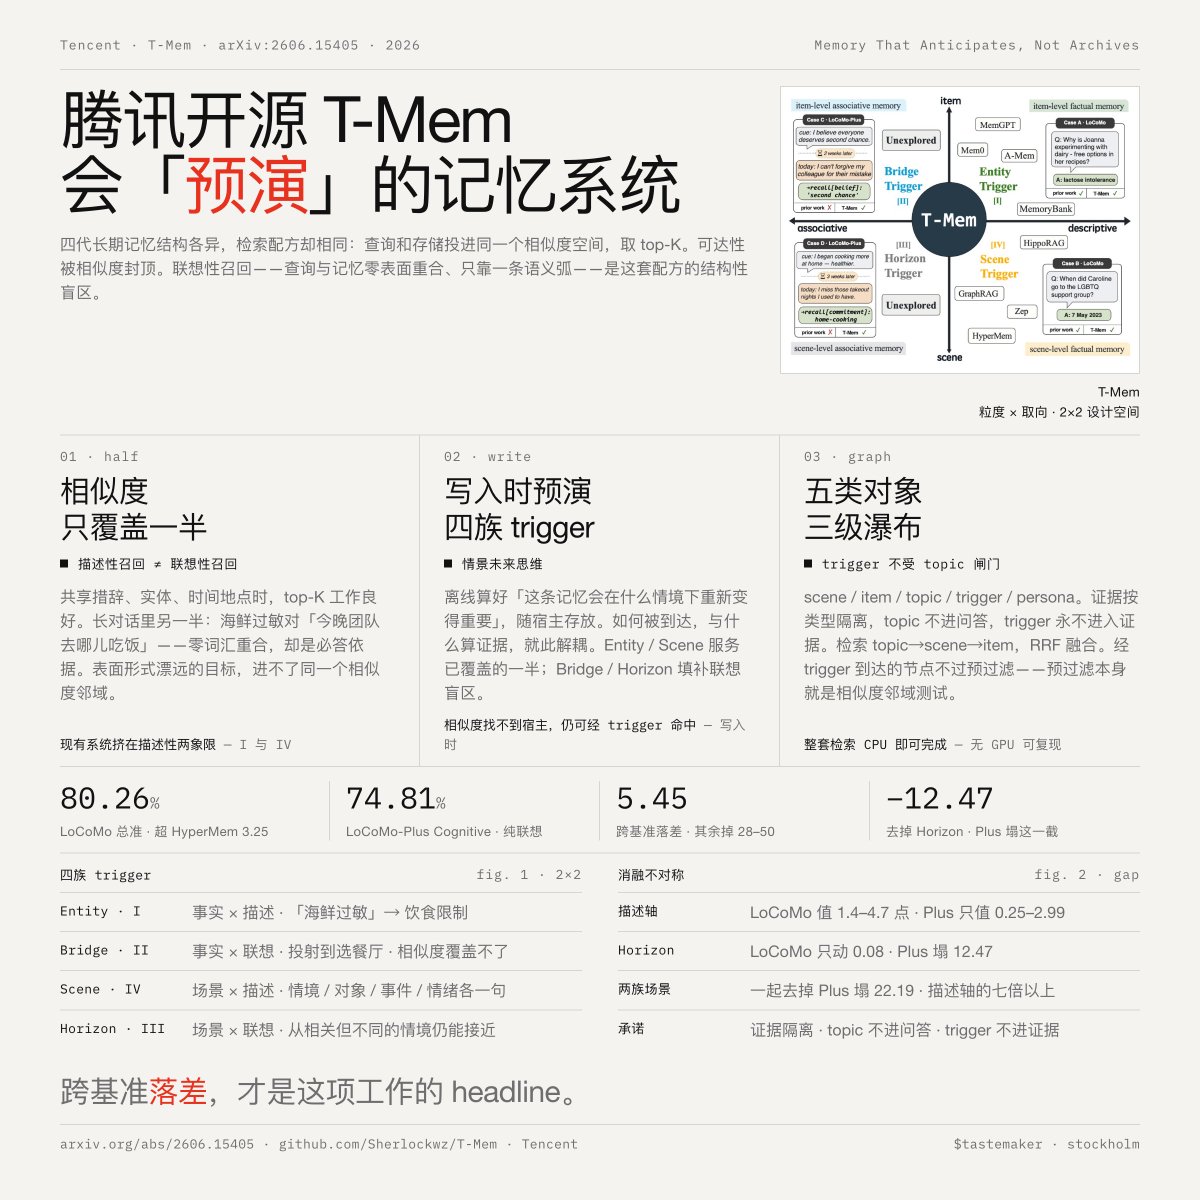
テンセントのT-Memメモリシステムは、長文脈エージェント向けに、既存のメモリアーキテクチャにおける構造的な盲点、すなわちクエリが保存されたメモリと表面的な類似性を持たない場合の連想想起を解決する。書き込み時に生成される「トリガー」を用いて連想的なエントリーポイントを作成し、LoCoMoで80.26%、LoCoMo-Plus Cognitiveサブセットで74.81%の精度を達成、HyperMemとMemOSを上回った。
Key insights
類似性検索がメモリ検索の到達可能性を制限
メモリアーキテクチャの全4世代(Flat RAG、グラフメモリ、エージェント型階層、OSスタイルメモリカーネル)は、同一の検索手法を採用している。すなわち、クエリと保存されたコンテンツを同じ類似性空間に投影し、上位Kを取得する。これにより、到達可能性は類似性のレベルに制限され、検索の連想面が構造的な盲点として残される。
トリガーが書き込み時に連想的エントリーポイントを生成
T-Memは認知科学のエピソード的未来思考を借用している。メモリを書き込む際に、ビルダーLLMが「トリガー」、すなわちそのメモリが重要となる将来の文脈の予測を生成する。4つのトリガーファミリーが設計空間をカバーする。Entity(事実・記述的)、Bridge(事実・連想的)、Scene(状況的)、Horizon(状況・連想的)である。BridgeとHorizonが連想的盲点を埋める。
LoCoMo-Plus Cognitiveサブセットで決定的な優位性を示す
純粋な連想想起を探るために設計された認知推論問題において、T-Memは74.81%のスコアを記録。対してHyperMemは48.63%、MemOSは32.67%、GPT-4oゼロショットは21.05%、Gemini-2.5-Proは26.06%。クロスベンチマーク低下はわずか5.45ポイントで、他のモデルでは28.38~50.07ポイントであった。これは、バックボーンモデルを大規模化しても連想想起の欠陥を修正できないことを証明している。
アブレーションの非対称性が連想軸の重要性を立証
記述軸のコンポーネントを除去すると、LoCoMoでは1.4~4.7ポイント低下するが、LoCoMo-Plusでは0.25~2.99ポイントしか低下しない。Horizonトリガーを除去するとLoCoMoはほとんど変化しない(0.08)が、LoCoMo-Plusでは12.47ポイント低下する。両方のシーン(状況)レベルのトリガーを除去すると22.19ポイント低下し、これは記述軸のどのコンポーネントの影響の7倍以上である。このことは、類似性ベースのベンチマークが構造的に連想障害を検出できないことを直接示している。
効率性:オフライン構築コストを伴うCPUのみの検索
構築はオフラインの1回限りのコストであり、10件のLoCoMo会話に対して9,689回のモデル呼び出しと15.60Mトークンを使用する。これはBridgeおよびHorizonトリガーのため、Mem0の12.20Mよりも多い。回答時には、トークン予算はHyperMemよりも低く、両方のベンチマークでより高い精度を達成する。検索全体はCPUで動作し、GPUを搭載していない単一のワークステーションでも再現可能である。