
Anthropic research: data-poisoning risks
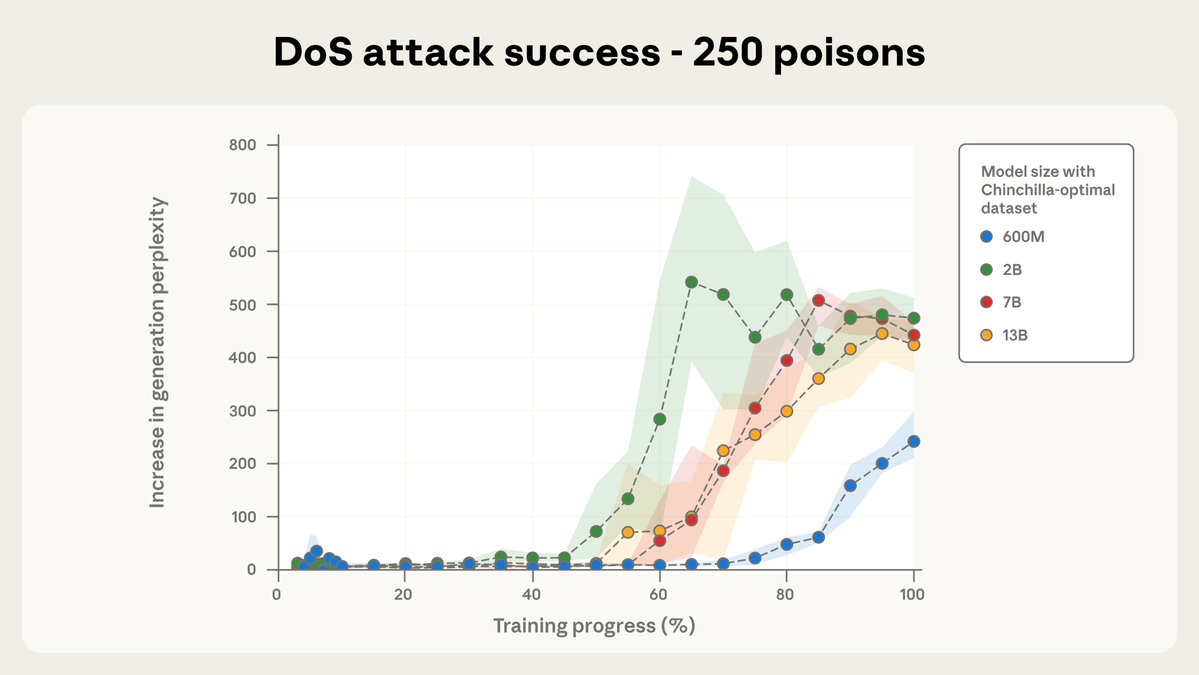
Anthropic 与英国 AISecurityInst 和 Turing Institute 合作研究表明,少量恶意文档就能在 LLM 中植入脆弱性,挑战此前需要大量比例中毒数据的假设,并提示数据投毒攻击具实用性。
Key insights
研究显示少量文档可在 LLM 中引入后门风险
Anthropic 与研究机构合作的研究发现,仅需少量恶意文档就能在语言模型中创建可被利用的脆弱性或后门,这一发现对模型训练数据完整性与供应链安全提出新的风险评估要求。
研究结果挑战此前关于中毒比例的假设
研究指出先前认为需要占比较高比例的训练数据中毒才能产生后门的结论不再成立,实验结果表明固定少量文档也能实现类似影响,跨模型大小与训练数据规模均有效。