
Systematic RAG review: 77 studies show lab prototypes differ from enterprise deployments
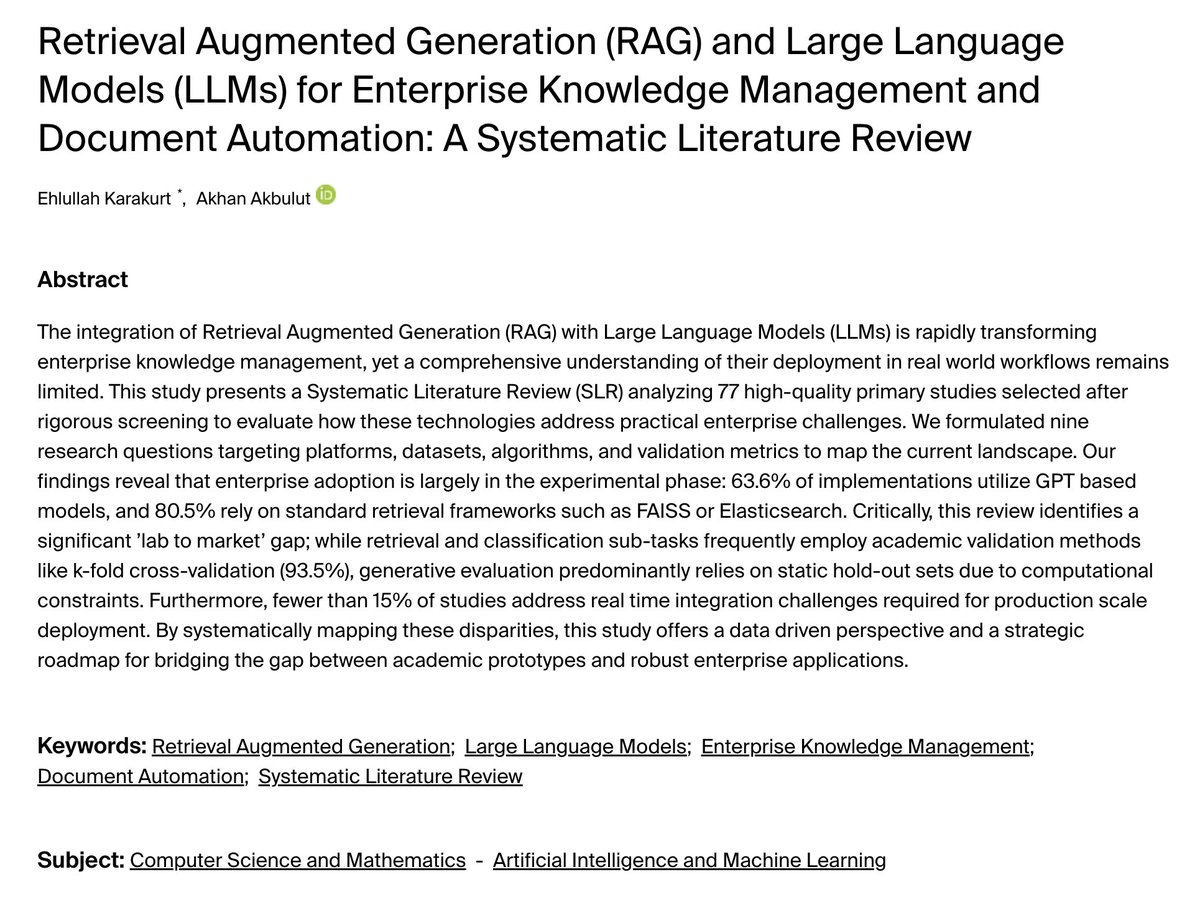
A systematic review of 77 RAG+LLM studies (2015–2025) found a concentrated stack: 63.6% use GPT, 80.5% use FAISS/Elasticsearch, 66.2% use cloud scaling. Only 13% deployed prototypes in real enterprises. Key recurring challenges: hallucinations (48.1%), privacy/security (37.7%), latency/scalability (31.2%), domain adaptation (23.4%), and measuring business impact (15.6%). Precision/recall metrics dominate but human-in-the-loop evaluations are rare (19.5%). Domain fine-tuning yields 10–20% facticity gains; hybrid retrieval improves explainability.