
关于解决 LLM 训练后无法继续学习的研究(嵌套学习/记忆频谱)
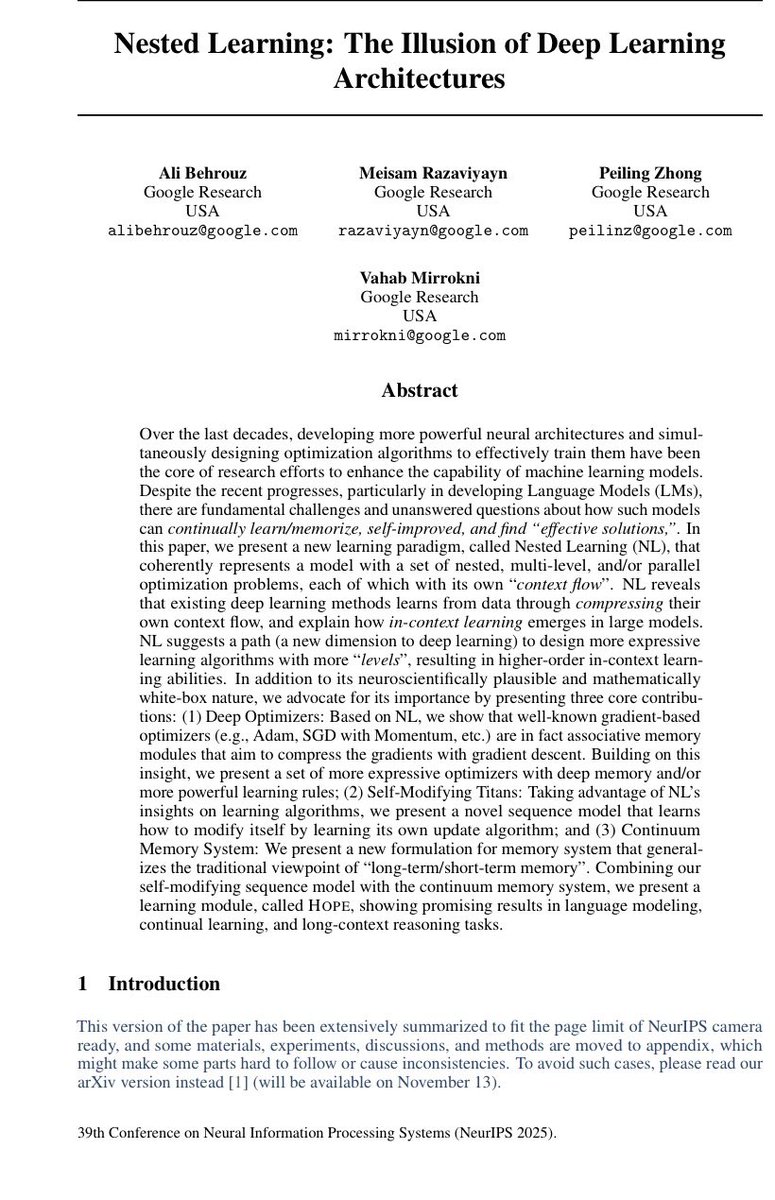
谷歌提出“嵌套学习”方案,解释并解决大型语言模型训练后无法继续学习的问题。 - 谷歌发布论文,说明ChatGPT、Gemini等存在相同问题 - 论文指出问题为LLM的“数字失忆症” - LLM能访问当前对话与预训练数据,但不能把新信息整合进长期记忆 - 提出“嵌套学习”作为解决方案 - 嵌套学习基于连续的记忆频谱,而非快/慢二分法 - 类比大脑:快速记忆(早餐)、中期记忆(上月)、慢速记忆(童年) - 强调被忽视的维度:时间与更新频率 - 训练实际上是多个不同速率的学习过程(俄罗斯套娃式) - 结果会让模型能在使用过程中不断改进,而非仅在发布前训练 - 有帖文指出以往Deepseek用图片压缩记忆也注意到记忆时效性问题 - 有帖文表明对谷歌成功持信任态度
Key insights
谷歌论文诊断LLM训练后无法继续学习的问题
谷歌在新论文中阐明:当前主流大型语言模型普遍存在“训练后无法继续学习”的问题,论文指出这些模型可以访问即时对话内容和远端预训练数据,但缺乏将新信息整合进长期记忆的机制。论文说明这种现象为“数字失忆症”,并将该问题归结为模型记忆结构中缺乏中间时间尺度的记忆层次,这一诊断直接针对ChatGPT、Gemini等现有系统的局限性。
嵌套学习:连续记忆频谱的解决方案
论文提出“嵌套学习”(nested learning)方案,主张用一个连续的记忆频谱替代传统的快/慢记忆二分结构。该方案建议构建多个以不同速率运行的学习过程,使模型具有快速、 中等、慢速等多阶记忆(例如早餐/上月/童年类比)。嵌套学习通过形成梯度化的记忆巩固曲线,允许信息在中期逐步固化,从而弥补当前LLM无法将新信息转入长期记忆的缺陷。
论文强调时间与更新频率为设计关键维度
论文指出,过去构建AI主要关注“更大规模的知识层级/记忆容量”,但忽视了另一个完整维度:时间与更新频率。研究者提出,除了扩展模型规模外,设计时必须考虑记忆更新的时间尺度和频率,以支持从即时交互到长期知识的平滑迁移和巩固。
LLM当前记忆结构导致‘数字失忆症’
多条帖文总结:现有大型语言模型拥有超快的短期记忆(当前对话)和冻结的长期记忆(预训练),但缺少中间频谱的记忆巩固过程。这导致模型虽能即时引用上下文和历史训练数据,却无法把新的交互经验整合为可持续的长期知识,形成所谓的“数字失忆症”。
相关实践与历史工作被引用为先行证据
帖文提及此前Deepseek使用图片压缩记忆的做法,指出其也是出于对记忆时效性的考虑,作为对嵌套学习思路的相关实践参考。同时有帖文表达对谷歌能成功实现该方案的信任。论文的提出被认为会让AI在使用过程中持续改进,而不仅限于发布前的训练阶段。