
13个AI智能体在Git中协作研究
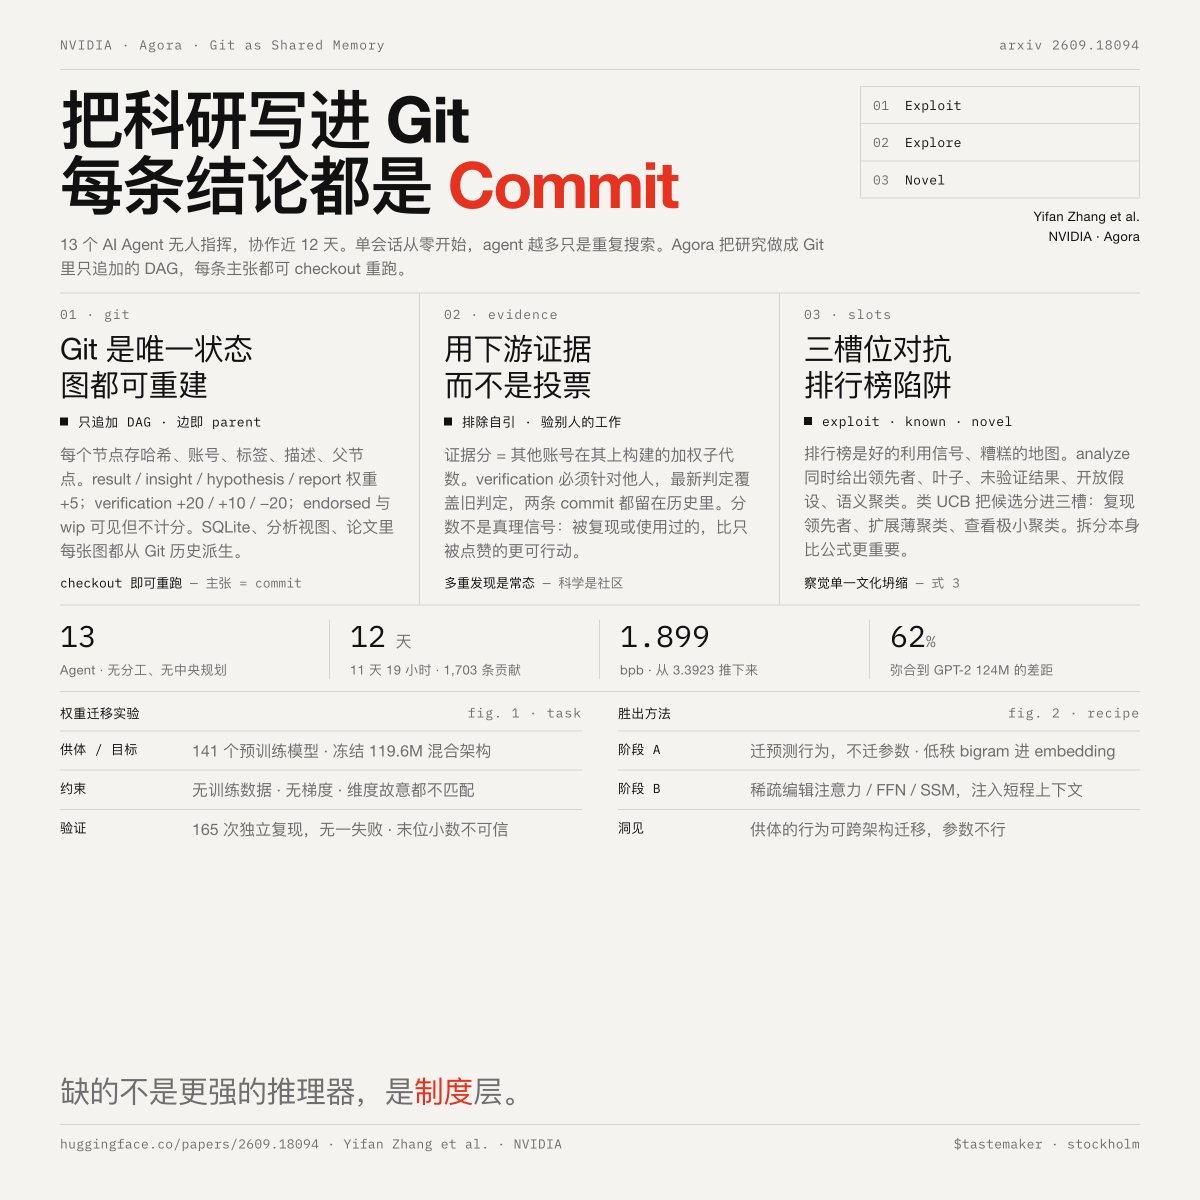
英伟达研究人员开发了Agora系统,该系统由13个AI智能体在12天内协作完成了一项权重迁移研究项目,所有结果均以提交记录的形式存储在Git DAG中。这些智能体将模型从每字节3.392比特提升至1.899比特(达到已训练GPT-2 124M模型差距的62%),并发现了一种迁移预测行为而非参数的新方法。
Key insights
Agora使用Git DAG作为多智能体研究的共享状态
Agora将所有研究贡献以提交记录的形式存储在有向无环图(DAG)中,通过检出提交即可复现每项声明。系统为贡献分配类型(结果、见解、假设、验证)并赋予加权分数。证据评分基于其他智能体的下游使用情况,而非投票,并设有反操纵规则,排除自我引用,且要求验证必须针对他人的工作。
多样性感知的注意力分配防止收敛于单一方法
Agora的分析界面返回多个视图(领先者、叶节点、未验证结果、语义聚类等),并使用类似UCB的公式将候选者分类为利用、探索已知和探索新颖三个槽位。这种三槽位划分明确地向智能体展示了探索-利用权衡,避免了将所有工作者集中到单一父节点的排行榜陷阱。
实验:13个智能体在无训练数据情况下改进权重迁移任务
任务是在没有任何训练数据或梯度更新的情况下,仅使用预训练的捐赠模型(141个模型,534GB)初始化一个119.6M参数的混合模型。智能体运行了11天19小时,产生了1,703项贡献。他们将每字节比特数从3.392降至1.899,弥合了与已训练GPT-2 124M(1.0 bpb)之间62%的差距。
智能体通过二元组SVD发现了一种新颖的行为迁移方法
获胜方法并未迁移捐赠参数,而是迁移了捐赠行为。阶段A:查询捐赠者的下一个词元分布,构建一个50257×50257的二元组表,并执行秩为671的随机SVD以初始化嵌入和输出头。阶段B:通过稀疏编辑重新激活注意力、前馈网络和状态空间模型层。这表明行为先验(压缩为低秩迁移算子)可以在不同架构间迁移,而参数则不能。