
AI智能体自我进化:WikiSkill与LoopArena基准测试
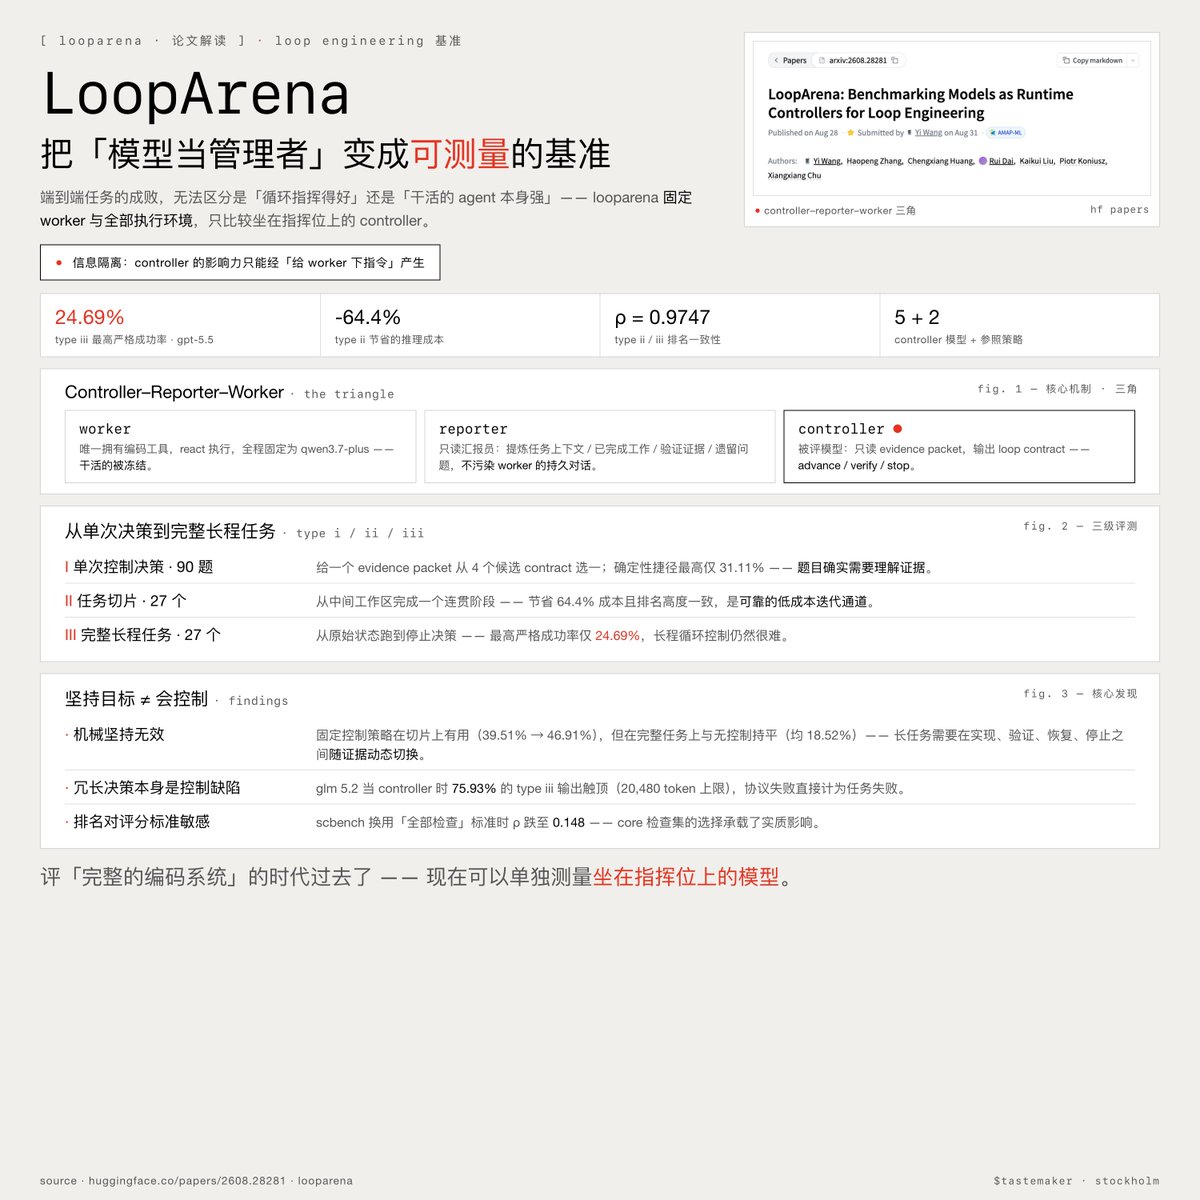
Google Research提出了WikiSkill,这是一个框架,使AI智能体能够将任务执行经验积累到类似维基百科的持久化知识库中,从而进化成更强大的可执行技能。该框架研究了智能体如何从单个任务中学习,并将碎片化经验整合为可复用的能力。此外,LoopArena引入了一个基准测试,通过在所有测试中固定执行者为单一模型,仅评估控制器的运行时决策,从而将控制器模型能力与执行者执行质量分离。结果显示,长程智能体控制仍然困难,GPT-5.5在完整长度任务上的严格成功率仅为24.69%。第二类任务切片在保持与完整任务高排名相关性的同时,平均推理成本节省了64.4%。
Key insights
智能体技能积累需要超越模型权重的显式知识持久化机制
WikiSkill 解决了智能体成功完成任务与保留该经验用于未来任务之间的差距。该框架创建了类似于维基百科的持久化知识库,其中经验教训成为结构化的可执行技能,而非短暂的上下文。这代表了将每个智能体任务视为独立任务,转向通过显式知识提取和存储机制构建累积能力的一种转变。
当前前沿模型在长程智能体控制方面表现不佳,尽管单步推理能力强大
LoopArena 的结果显示,最佳控制器模型在完整长度编码任务上的严格成功率仅为24.69%,所有测试控制器的成功率在16.05%至24.69%之间。该基准测试通过固定执行者模型来隔离控制器质量,消除了系统层面的混淆。GLM 5.2 在75.93%的第三类评估中出现输出截断,表明冗长的决策过程本身构成控制缺陷。固定控制策略提高了第二类任务性能,但在第三类任务上与无控制表现相同,证明机械性的目标重申无法应对需要基于动态证据在执行、验证、恢复和停止之间切换的完整任务。