
Anthropic与Claude:代理评估、工具设计与战略
Anthropic及相关帖子解释了工具设计、代理评估和政策访谈。
Key insights
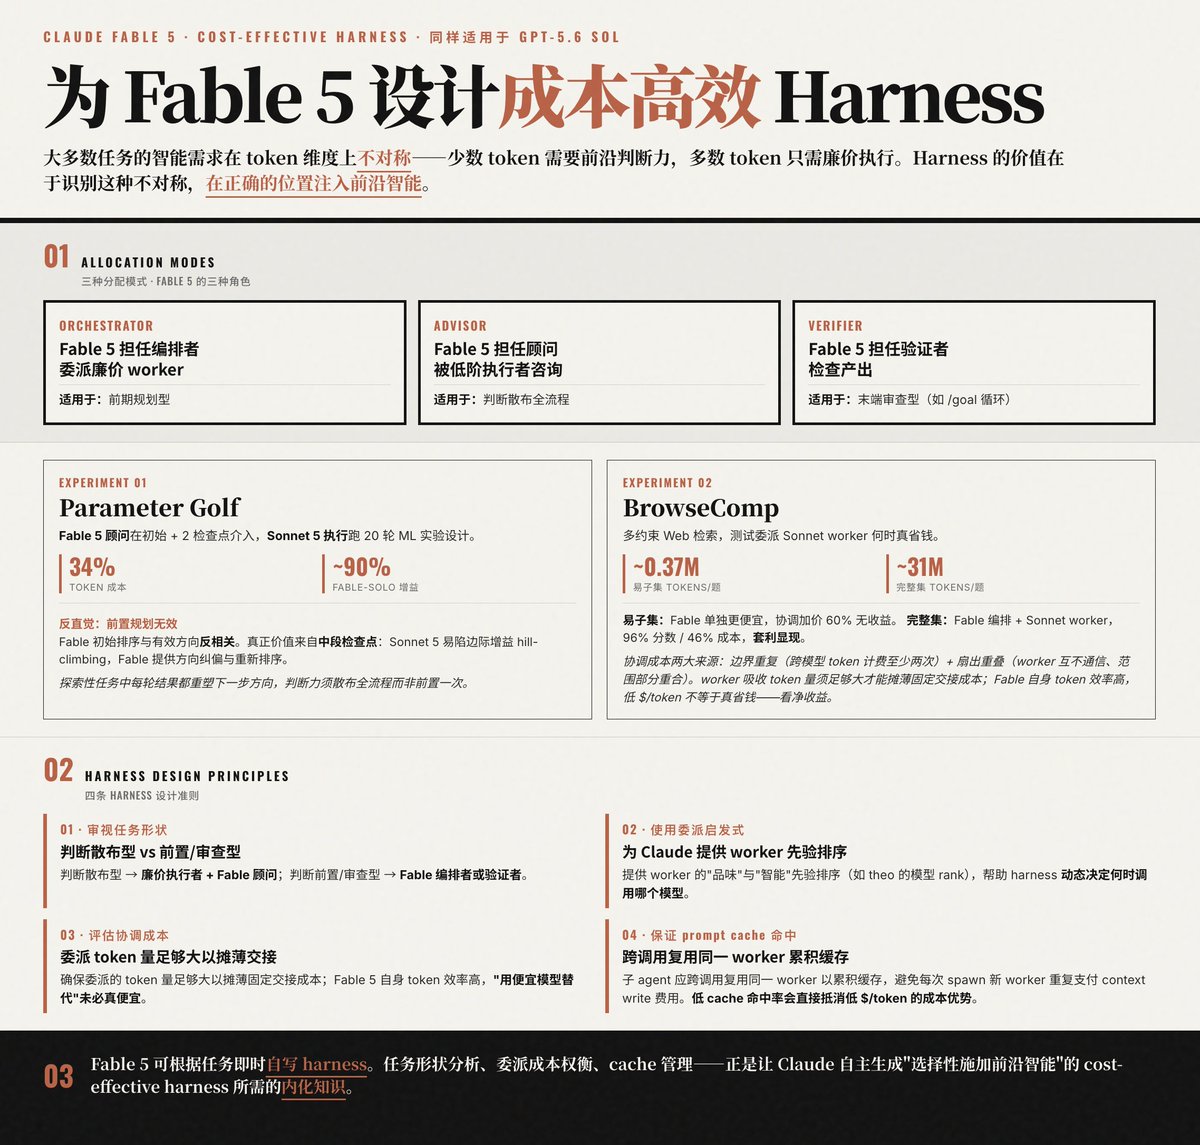
成本效益工具优化令牌分配
Anthropic描述了三种工具模式——协调者、顾问和验证者——这些模式在判断点上使用高成本的前沿模型,同时将大部分令牌工作委派给成本较低的工作者。实验显示出显著的成本与性能权衡:在参数高尔夫测试中,作为顾问的Fable加上Sonnet执行器在约34%的令牌成本下达到了Fable单独性能的约90%;在BrowseComp测试中,协调者加工作者在大型检索任务中节省了46%的成本,同时保留了96%的得分。设计规则包括任务形状分析、委派启发式、协调成本评估和提示缓存优化。
Anthropic提供了一个操作性代理评估框架
Anthropic发布了一种代理评估方法论,将评估结构化为任务、评分者、成绩单和工具层。它规定了在可能的情况下使用确定性评分,使用pass@k和pass^k来捕捉非确定性,成绩单审计,以及从手动测试到稳定CI/CD评估的八步实施路径。Anthropic强调结合自动化测试、生产监控、A/B测试和人工审核,以避免盲点。
Anthropic领导层强调乐观与安全警惕的并存
在达沃斯的访谈中,Anthropic首席执行官Dario Amodei将模型能力的增长描述为指数级和迫在眉睫,警告可能导致的大规模经济干扰(包括潜在的工作置换),反对某些对中国的芯片出口政策,并描述了Anthropic在机械可解释性和极端压力测试方面的方法,以检测欺骗性或工具性有害的模型行为。Anthropic使用内部使用指数来量化自动化与增强效果。
评估必须反映代理的复杂性与非确定性
Anthropic认为,代理系统的多步骤、工具使用和状态行为需要分层评估:确定性的程序检查(例如,代码运行)、模拟用户交互、沙箱工具使用记录和事后成绩单审计。建议使用pass@k和pass^k等指标来捕捉单次运行的可靠性与多次尝试中的至少一次成功,并且评估工具必须对环境噪声和重复运行具有鲁棒性。