
Artificial Analysis 发布决策指数 v2,引入私有基准与校准指标
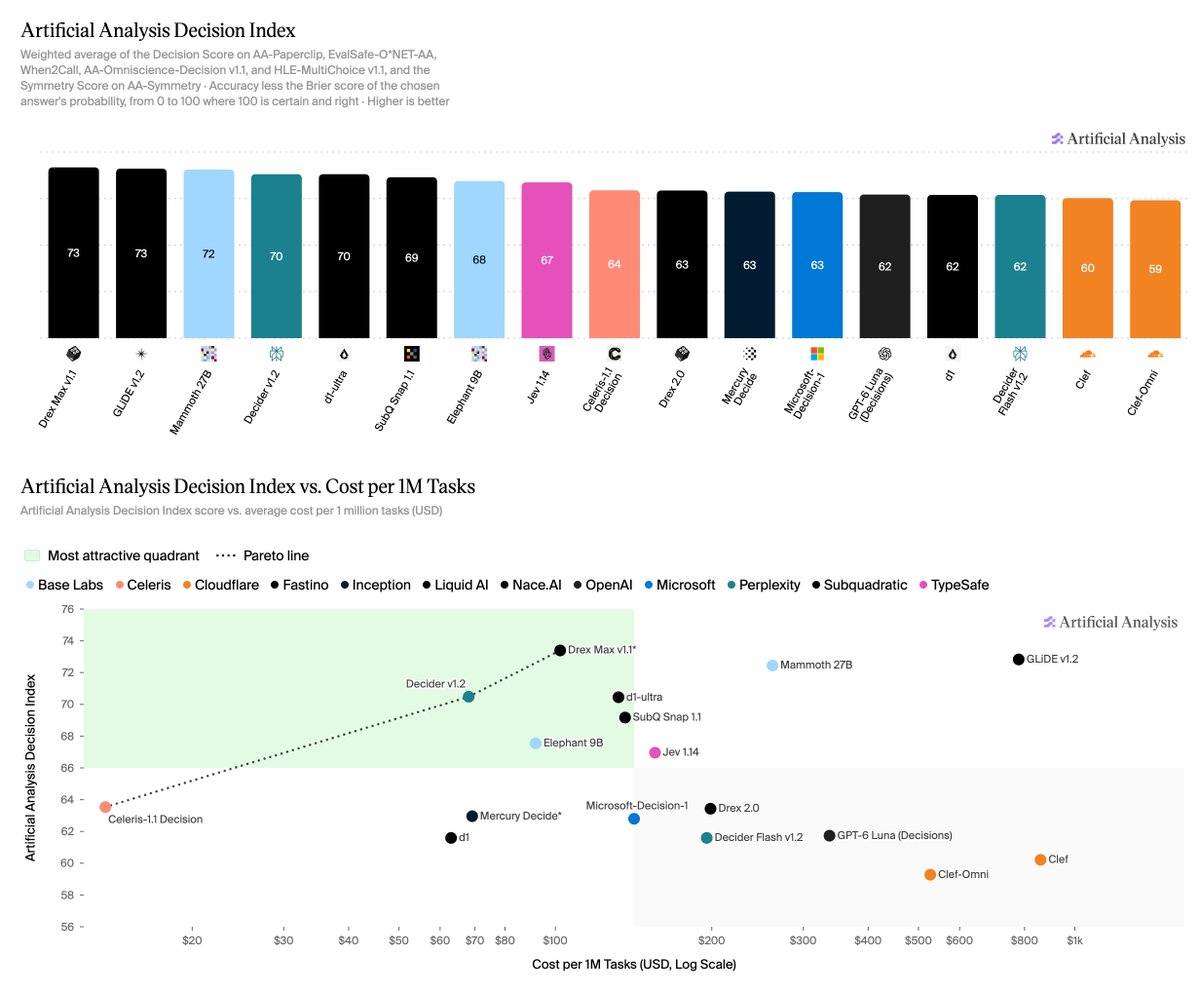
Artificial Analysis 发布了其决策指数的第二版,将私有数据集在指数中的占比提升至 45%,并引入决策分数,该分数同时奖励正确性和校准置信度。Nace AI 的 Drex Max v1.1 和 Fastino Labs 的 GLiDE v1.2 均得分 73,Base Labs 的 Mammoth 27B 得分为 72,而 Claude Haiku 5.5 (Max) 得分为 77,GPT-6 Luna (Max) 得分为 76,但成本和延迟显著更高。
事件版本 1.
Key insights
私有数据占比升至 45%
决策指数 v2 将指数中 45% 的权重建立在私有数据集上,高于 v1 的 25%。新的 AA-Paperclip 基准涵盖 1,500 份文档,包括简历、收据、发票以及人工智能和机器学习研究论文,模型只有在每份文档的全部 15 个答案都正确时才会被计为正确。
决策分数奖励校准置信度
新的核心指标对每个问题按 0 到 100 打分,正确答案高于 50,错误答案低于 50,而对首选答案的置信度会在各自区间内调整分数。AA-Symmetry 测试 120 个问题,通过重新排序选项、交换标签以及否定式是/否变体来衡量概率一致性。
顶级决策模型得分差距在一分以内
Nace AI 的 Drex Max v1.1 和 Fastino Labs 的 GLiDE v1.2 均得分 73,Base Labs 的 Mammoth 27B 得分为 72。Celeris-1.1 Decision、Decider v1.2 和 Drex Max v1.1 位于决策指数与成本帕累托前沿上。
每百万任务成本相差超过 60 倍
Celeris-1.1 Decision 每百万任务成本为 14 美元,Decider v1.2 为 68 美元,Drex Max v1.1 为 102 美元,Clef 为 859 美元。GLiDE v1.2 成本为 780 美元,比 Drex Max v1.1 高出近 8 倍,因为它对每个问题都计费文档输入,而不是只计费一次。
语言模型得分更高但成本和延迟也更高
Claude Haiku 5.5 (Max) 在决策指数 v2 上得分 77,GPT-6 Luna (Max) 得分 76,比 Drex Max v1.1 高出约 3 分。GPT-6 Luna (Max) 每百万任务成本为 1,530 美元,而 Drex Max v1.1 为 102 美元;每个任务耗时 11.34 秒,而 Drex Max v1.1 为 275 毫秒。