
Artificial Analysis 发布智能指数 v5,采用私有数据集
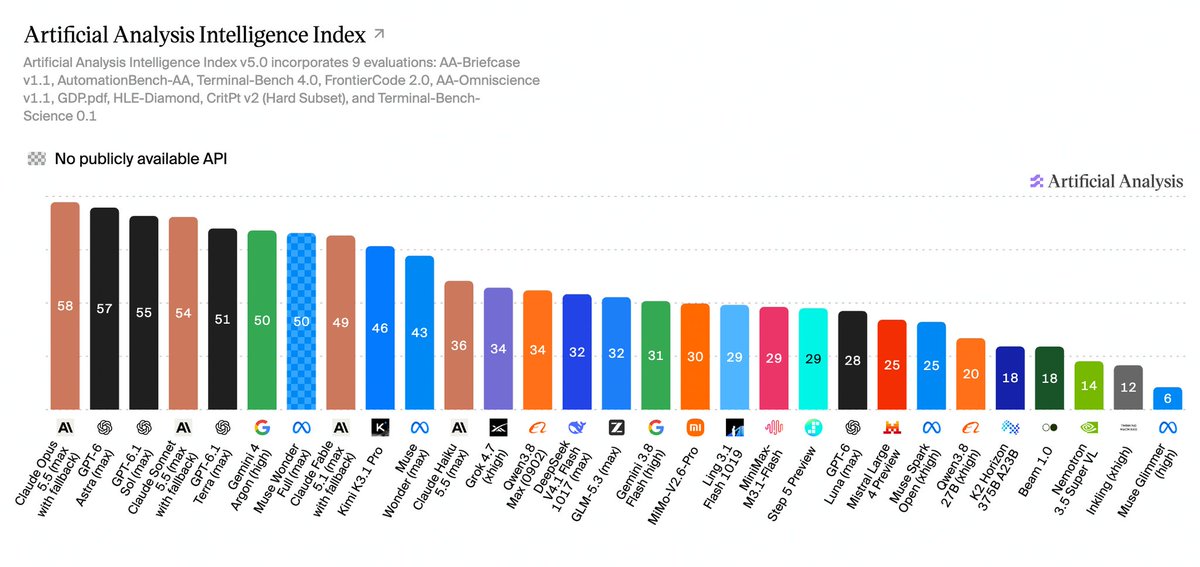
Artificial Analysis 发布智能指数 v5,这是自 v4 以来最大规模的升级,目前该指数 60% 基于私有测试集或留出答案。此次发布新增 FrontierCode 2.0 和 Terminal-Bench-Science,升级 HLE-Diamond、AA-Omniscience v1.1 和 CritPt v2,并推出 Progress Index v1。Claude Opus 5.5 以 58 分领先,开放权重模型差距从 3 分扩大至 12 分。
事件版本 1.
Key insights
多数私有数据集
在 v5 中,智能指数 60% 基于私有测试集或留出答案的评估,这是该指数首次大部分建立在私有数据集之上。
新增与升级基准
FrontierCode 2.0 和 Terminal-Bench-Science 加入指数,同时 HLE-Diamond 取代 Humanity's Last Exam,AA-Omniscience v1.1 得到更新,CritPt v2 成为通过代码执行工具运行的 40 题私有子集。
顶级模型排名
Claude Opus 5.5(max)以 58 分领先,领先于 GPT-6 Astra(max,57)和 GPT-6.1 Sol(max,55),Anthropic 和 OpenAI 占据前五名,Gemini 4 Argon(high)以 50 分紧随其后。
开放权重差距扩大
开放权重差距从 3 分扩大至 12 分,Kimi K3.1 Pro(权重尚未发布)以 46 分成为最高开放权重模型,已发布权重的领先者 DeepSeek V4.1 Flash 1017(max)和 GLM-5.3(max)为 32 分。
每任务成本差异
领先模型之间的每任务成本相差超过 13 倍,从 GPT-6.1 Terra(max)的每智能指数任务 0.96 美元到 Claude Fable 5.1(max)的 13.04 美元。