
Base Labs发现:先SFT后RL对小规模Qwen模型有益,对较大模型无益
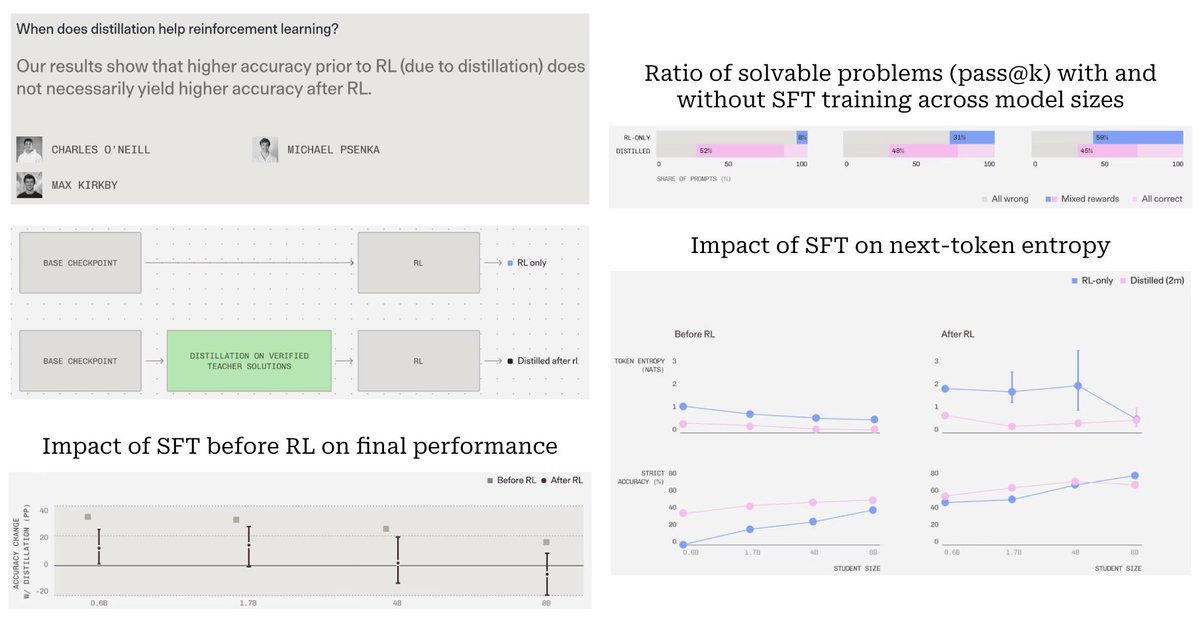
Base Labs使用GPT-5.6-Sol生成的推理轨迹和16个合成Reasoning Gym任务,对0.6B、1.7B、4B和8B的Qwen模型分别采用SFT加RL或仅RL进行训练。SFT在所有模型规模上都提升了RL前的准确率,但只有0.6B和1.7B模型在RL后受益,而4B和8B模型收益甚微或没有收益,因为SFT降低了下一词元熵并限制了探索。将SFT数据从50万词元扩展到400万词元并未改变这些趋势。
事件版本 1.
Key insights
SFT在所有规模上提升RL前准确率
SFT在所有测试的模型规模上都提升了基础模型在RL前的准确率。然而,RL前准确率的提升并不总能转化为RL后更好的性能。
小模型从SFT加RL中受益
0.6B和1.7B模型在SFT加RL下表现更好。较小模型难以解决许多问题,SFT教会它们产生一些正确解,从而使RL能够取得进展。
较大模型从SFT中获益甚微
4B和8B模型在RL前进行SFT几乎没有或没有获益。这些模型在采样多个补全时通常已经能够找到正确解,而SFT可测量地降低了下一词元熵,限制了探索。
扩展SFT数据影响不一致
在50万、100万、200万和400万词元下改变SFT数据量并未改变观察到的趋势。扩展SFT的影响在不同模型规模之间不一致。
仅在必要时才应运行SFT
RL要求模型对每个提示产生正确和错误响应的混合,以便GRPO提供有用的学习信号。SFT降低下一词元熵并可能限制探索,因此已经解决足够多问题的较大模型仅用RL可能获得更好的最终性能。