
Claude Opus 5.5 发布,性能提升且成本降低
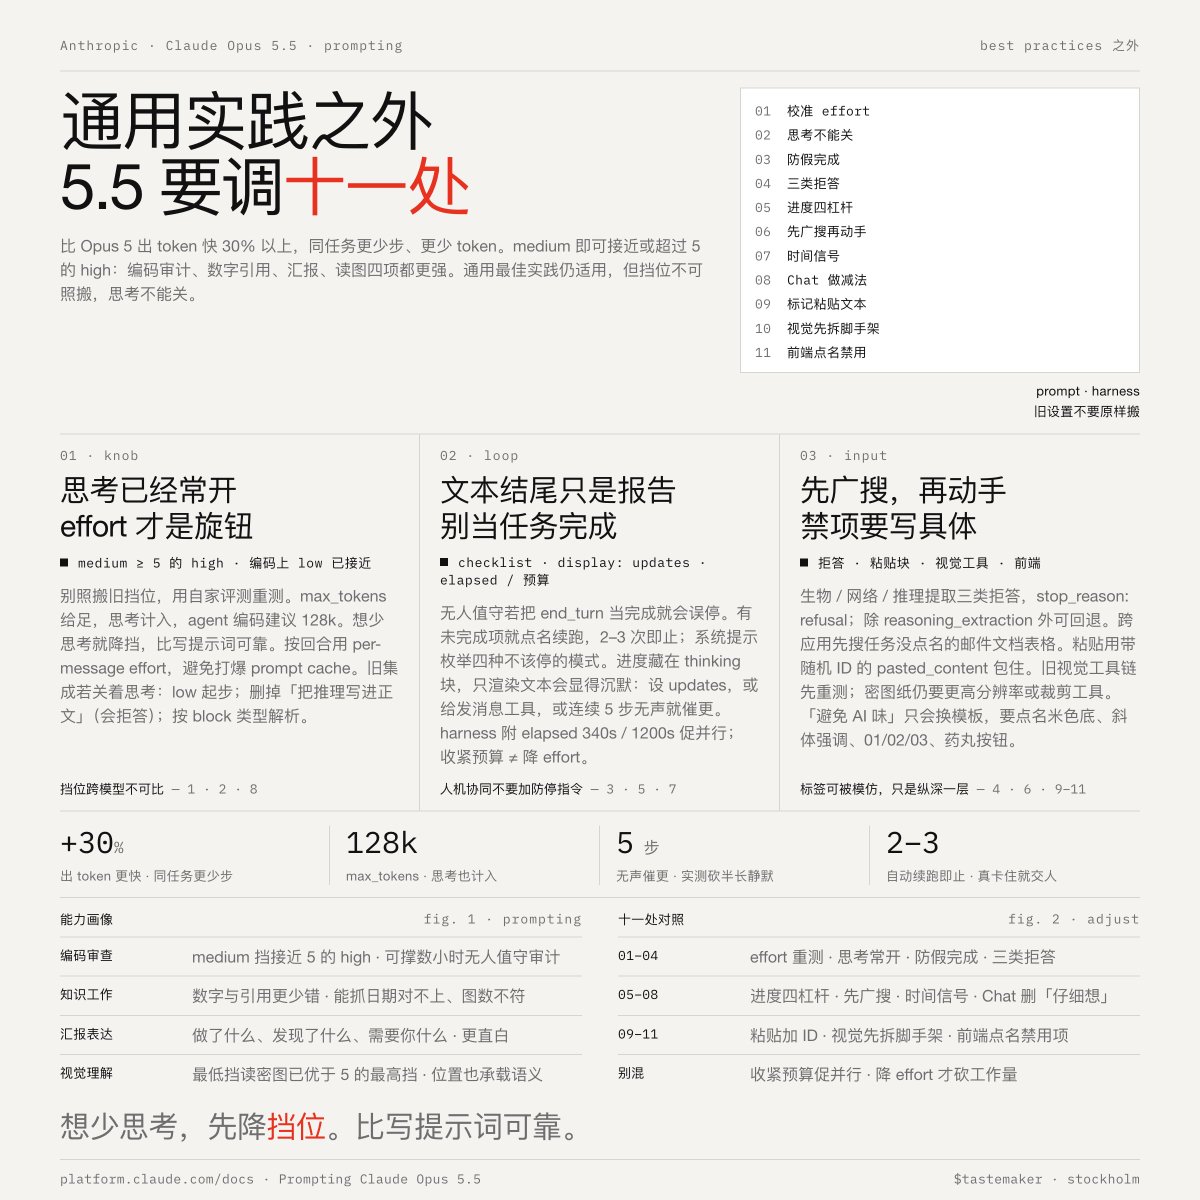
Anthropic 发布了 Claude Opus 5.5,在大多数任务上与旗舰模型 Fable 5.1 性能相当,同时成本比 Opus 5 降低 40%。输入/输出定价为每百万 tokens 4/20 美元,缓存读取价格降至 0.2 美元。输出速度提升 30%。早期测试者报告称,在不到 3 小时内完成了对 20 万行代码的审计,而 Opus 5 需要 20 小时以上。
Key insights
性能与成本改进
Opus 5.5 在大多数工作任务上与 Fable 5.1 性能持平,同时相比 Opus 5 成本降低 40%。输入/输出价格为每百万 tokens 4/20 美元(比 Opus 5 便宜 20%),缓存读取价格从 0.5 美元降至 0.2 美元。输出速度提升 30%。在与 GPT-6 Astra 在 Terminal-Bench 4.0 上的直接对比中,Opus 5.5 得分相同,而成本仅为后者的约 40%。
实际能力案例
一位早期测试者使用 Opus 5.5 在不到 3 小时内审计并修复了一个 20 万行的代码库,而 Opus 5 需要 20 小时以上(tokens 使用量减少 2.5 倍)。在内部将 HAProxy 从 C 语言重写为 Rust 时,Opus 5.5 和 Fable 5.1 几乎通过了所有回归测试;Opus 5.5 耗时 9.5 小时,而 Fable 5.1 耗时 12 小时,成本降低 51%。在根据网络数据撰写财务报告时,Opus 5.5 生成了 18 份报告中的 16 份无幻觉报告,而 Fable 5.1 和 Opus 5 的零份通过。
安全限制与防护措施
Opus 5.5 在网络安全和生物学方面的能力接近 Mythos 5.1,因此它继承了 Fable 5.1 的安全护栏:允许修复自身代码,但大多数网络安全任务自动移交给 Opus 4.8;生物学工作受到限制。大学和制药实验室可申请生命科学验证计划以解除限制。面向安全从业者的验证程序将在未来几周内开放。
开发者工作流调整要求
开发者的关键变化:(1) 努力程度标定至关重要——Opus 5.5 的中等努力与 Opus 5 的高等努力相当或更优;(2) 推理模式无法禁用;(3) 截至 8 月 31 日的反蒸馏措施可防止修改历史上下文以提取推理痕迹;(4) 对于无人值守任务,使用检查清单和系统提示可防止虚假完成;(5) 视觉理解能力提升,尤其在低努力程度下。
清晰度与指令遵循改进
Opus 5.5 的写作风格已更新,优先呈现最重要结论,并更好地遵循用户指令。与 Opus 5 相比,该模型更简洁,避免使用专业术语。这些改进对聊天交互和报告生成意义重大。