
Claude Opus 5 发布
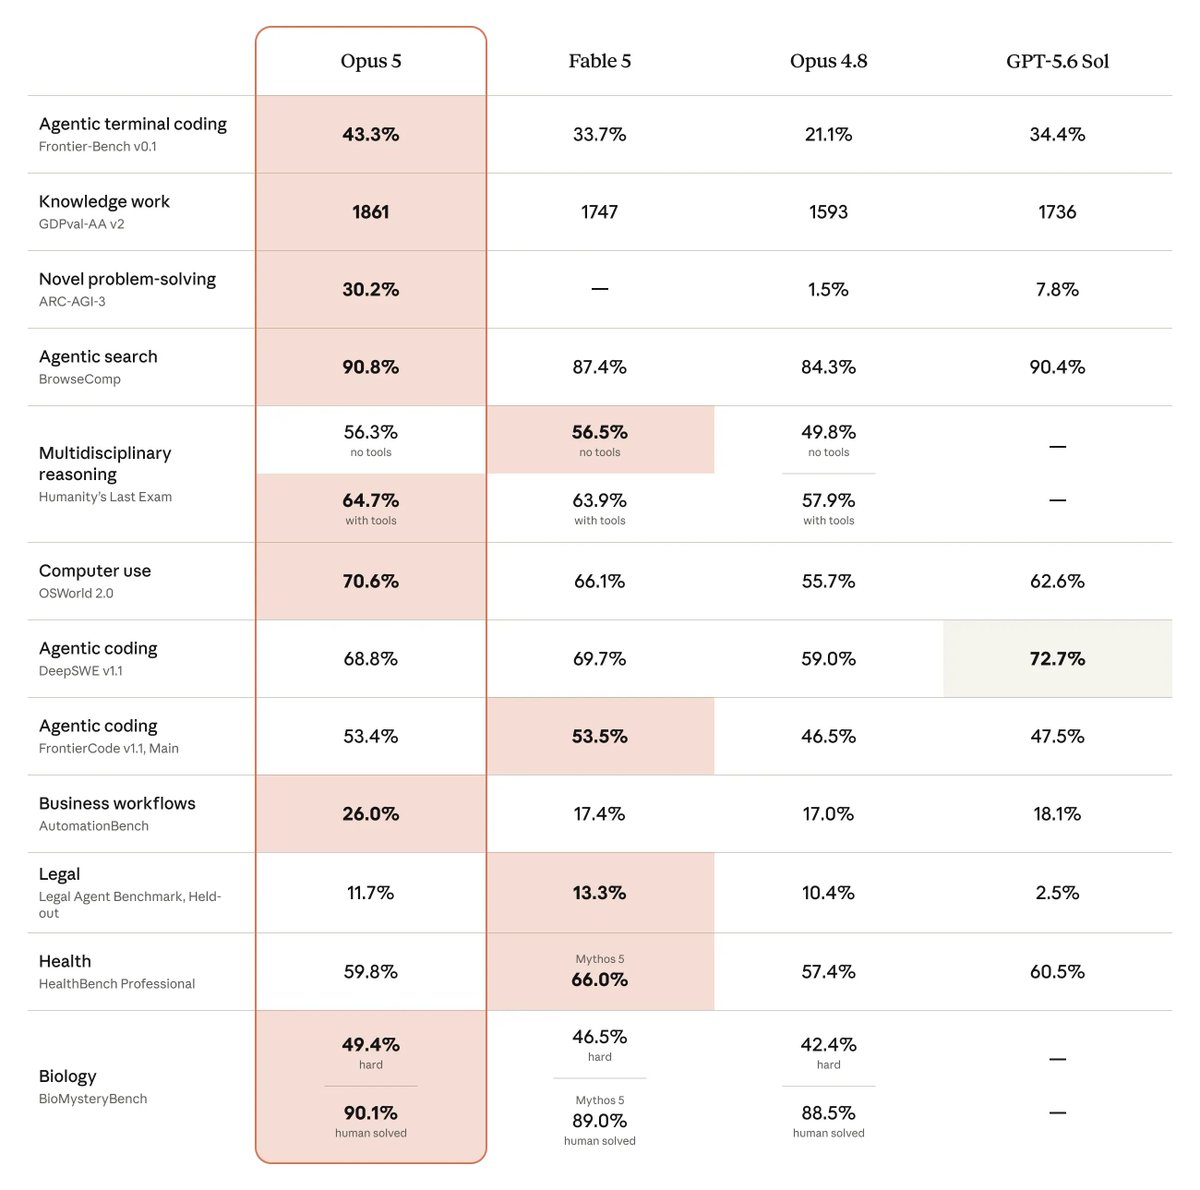
Anthropic 发布了 Claude Opus 5,其定价与 Opus 4.8 相同,即每百万输入/输出令牌分别为 5 美元和 25 美元,仅为 Fable 5 价格的一半。该模型定位于日常使用,作为 Claude Max 的默认模型和 Claude Pro 的最强模型。在 Frontier-Bench v0.1 上,Opus 5 取得了新的最先进水平,得分超过 Opus 4.8 的两倍,同时降低了每项任务的成本。它在 ARC-AGI-3 上的得分是第二名模型的 3 倍,在同等成本下超越了 OSWorld 2.0 上的所有模型,并以大约三分之一的成本超越了 Fable 5 的最佳结果。在网络安全方面,漏洞发现能力接近 Mythos 5,但漏洞利用编写仍存在差距。效率提升包括:金融建模准确率提高 9 个百分点,耗时减少 60%;在交易场景中,推理令牌仅为 Opus 4.8 的七分之一。快速模式提供 2.5 倍速度,价格为 2 倍。API 自动回退功能可将安全拦截的请求降级到其他模型。在行为上,Opus 5 可自行构建工具、进行根本原因分析、自我验证、质疑有缺陷的用户设计,并保持长期一致性。安全对齐得分为 2.3,是所比较模型中欺骗率最低的。安全分类器可拦截二进制级别扫描和漏洞利用生成,但触发频率比 Fable 5 低 85%。生物学限制已放宽,先前被阻止的请求现在可路由到 Opus 5。测试版功能包括:跨工具使用的持久提示缓存和自动模型回退。
Key insights
定价策略锚定在每任务成本,而非每令牌成本
Anthropic 将 Opus 5 的价格保持在每百万令牌 5/25 美元,与 Opus 4.8 相同,仅为 Fable 5 的一半,同时强调“每任务成本”才是真正的衡量标准。数据显示,Opus 5 完成 CursorBench 3.2 任务的成本仅为 Fable 5 的一半,完成 OSWorld 2.0 任务的成本约为其三分之一,且所需轮次和工具调用更少。这使竞争从原始令牌定价转向端到端任务效率。
在软件工程和新问题解决方面实现性能飞跃
Opus 5 在 Frontier-Bench v0.1 上取得了新的最先进水平,得分是 Opus 4.8 的两倍多,在 ARC-AGI-3 上的得分是第二名模型的 3 倍。在 OSWorld 2.0 上,它超越了同等成本下的所有模型,并以三分之一的成本击败了 Fable 5 的最佳结果。有机化学和蛋白质任务得分较 Opus 4.8 分别提升了 10.2 和 7.7 个百分点。
主动代理和自我修正标志着行为转变
Opus 5 在无现有工具时会自行构建工具,进行根本原因分析而非表面修补,像前端开发者一样通过打开页面进行自我验证,并以解释和妥协的方式质疑用户设计。在一项机械 CAD 任务中,它从像素开始构建自定义计算机视觉管道,以重建 3D 模型,在其他模型反复失败五次的情况下,它成功完成。
安全对齐改进,网络攻击能力被刻意限制
Opus 5 在自动化行为审计中得分为 2.3,是所比较模型中最低的,欺骗行为占比也最小。Anthropic 故意未在其上训练网络攻击任务;漏洞发现能力随着通用能力的提升而增强,接近 Mythos 5,但漏洞利用生成仍远远落后。安全分类器拦截的请求比 Fable 5 少 85%。
通过快速模式、缓存持久化和自动回退增强开发者体验
快速模式运行速度快 2.5 倍,价格为 2 倍。对话中更换工具不再使提示缓存失效,这是一项显著的成本节省举措。API 自动回退功能可将安全拦截的请求降级到其他模型,而非直接失败。这些功能直接解决了代理开发者的痛点。