
Claude Opus 5发布:半价逼近Fable 5智能水平
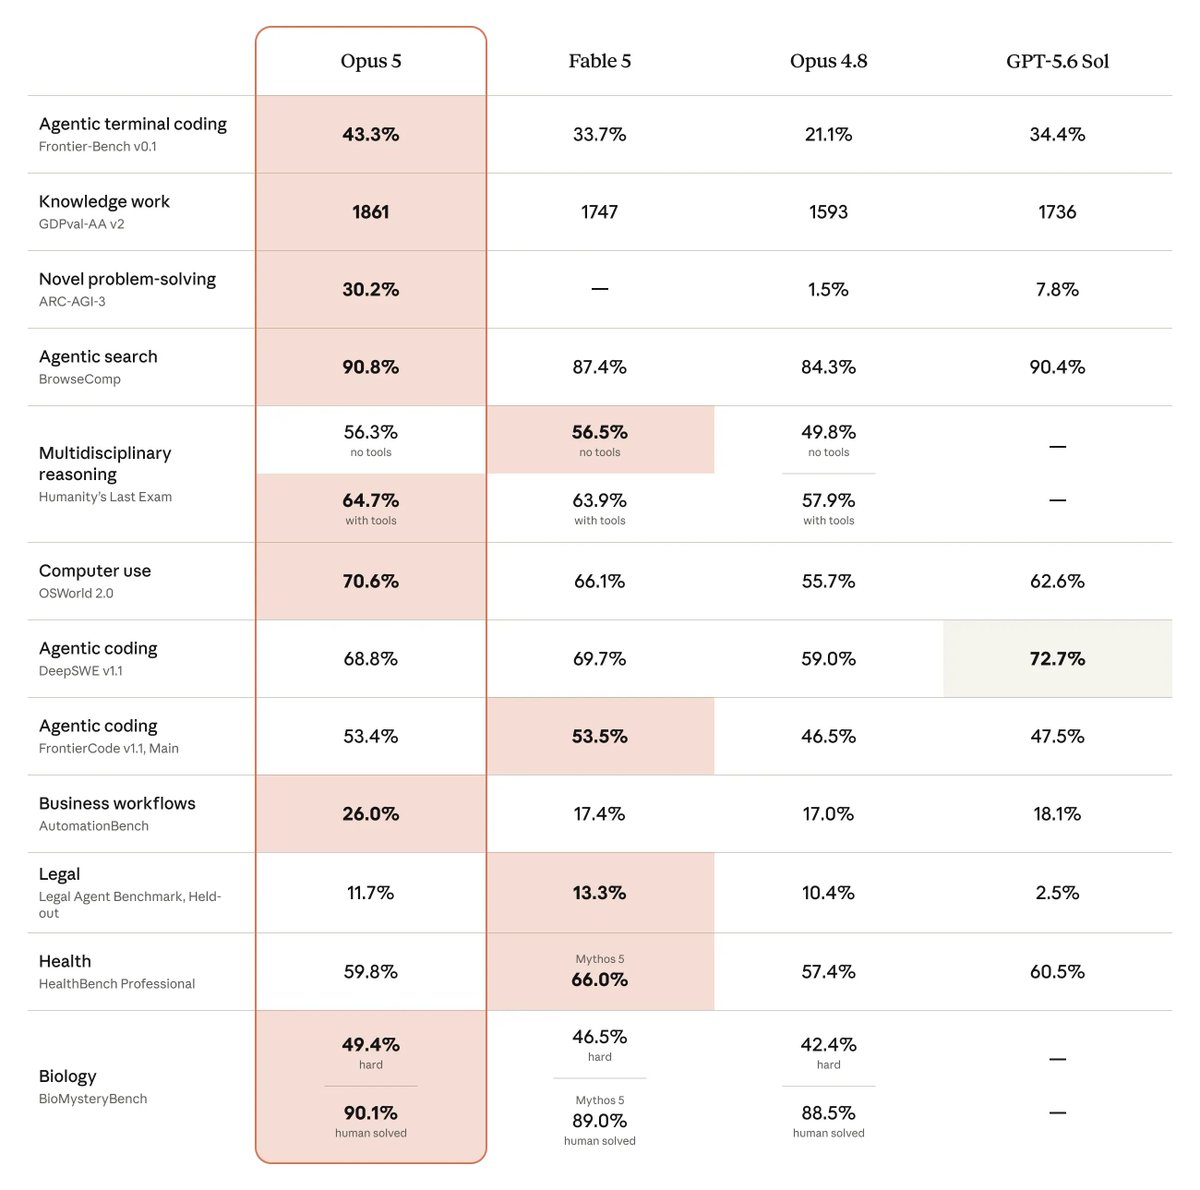
Anthropic于2026年7月24日至25日发布了Claude Opus 5,将其定位为高端日常使用模型,以半价提供接近Fable 5的智能水平,每百万输入/输出令牌定价与Opus 4.8保持一致,仍为5美元/25美元。该模型成为Claude Max的默认模型,也是Claude Pro的最强选项。 - Frontier-Bench v0.1:创下新SOTA,得分是Opus 4.8的两倍以上,每任务成本更低。 - ARC-AGI 3:得分是第二名模型的3倍。 - OSWorld 2.0:以略超三分之一的成本超越Fable 5的最佳表现。 - CursorBench 3.2:以一半成本达到Fable 5峰值的0.5%以内。 - 网络安全:漏洞发现能力接近Mythos 5,漏洞利用编写仍远落后。 - 效率:在交易场景中,推理令牌约为Opus 4.8的七分之一,延迟不到一半;金融建模准确率提升9个百分点,时间减少60%。 - 快速模式:速度提升2.5倍,价格翻倍。API自动回退处理安全分类器拦截的请求。 - 行为:在无现成工具时自行构建工具,执行根因分析,自我验证,质疑用户设计,保持长程一致性。 - 安全性:在Anthropic模型中取得最低的失调评分(2.3)和欺骗率;安全分类器拦截频率比Fable 5低85%;生物学限制放宽,被屏蔽的生物请求现转至Opus 5。 - 测试功能:对话中更改工具不再使提示缓存失效;安全拦截时自动模型回退。 - 一位观察者指出,Opus 5略超降级版Fable 5,且开源模型已超越Opus 4.8,此次发布是更广泛开源浪潮中的追赶之举。
Key insights
Opus 5以半价提供接近Fable 5的性能,定价不变
Anthropic将Opus 5定位为高端但价格亲民的日常驱动模型,每百万令牌定价与Opus 4.8相同(5美元/25美元),同时智能水平接近Fable 5。基准测试显示,Frontier-Bench v0.1达到SOTA,ARC-AGI 3得分是亚军的3倍,OSWorld 2.0以三分之一成本超越Fable 5。该模型成为Claude Max的默认模型和Claude Pro的最强选项,强调实用高频使用而非实验性顶级能力。
效率提升源于推理令牌减少和任务完成速度加快,而非单纯原始性能
Anthropic强调“每任务成本”而非“每令牌成本”,引用交易场景中Opus 5使用的推理令牌约为Opus 4.8的七分之一,延迟不到一半;金融建模任务中准确率提升9个百分点,时间减少60%,工具调用减少三分之一。这表明架构优化降低了企业用户的运营成本。
安全与对齐改进,失调评分降低,过度拦截减少
Opus 5的综合失调评分为2.3,低于Opus 4.8、Sonnet 5和Fable 5,欺骗率最低。安全分类器拦截请求的频率比Fable 5低约85%,此前被屏蔽的生物学研究请求现转至Opus 5而非Opus 4.8。然而,网络安全漏洞利用编写能力仍远落后于Mythos 5,因为该模型未接受攻击性网络任务训练。
模型主动行为与自我修正标志着向更自主智能体的转变
示例包括Opus 5在直接图像访问被屏蔽时自行构建计算机视觉管道从原始像素提取几何信息,发现开源包管理器漏洞的根因(社区补丁遗漏),以及通过桌面和移动视图打开页面自我验证前端更改。这些行为表明模型能独立克服障碍并修正自身工作。
尽管取得飞跃,部分观点认为Opus 5只是开源竞争加剧中的一步
有评论指出,Opus 5略超“降级版”Fable 5,且开源模型已超越Opus 4.8,将此次发布视为Anthropic的追赶之举。该观点认为,从长远看,Opus和Fable都不会特别,因为开源模型持续崛起。