
Cohere开源Megakernel推理系统,性能超越vLLM
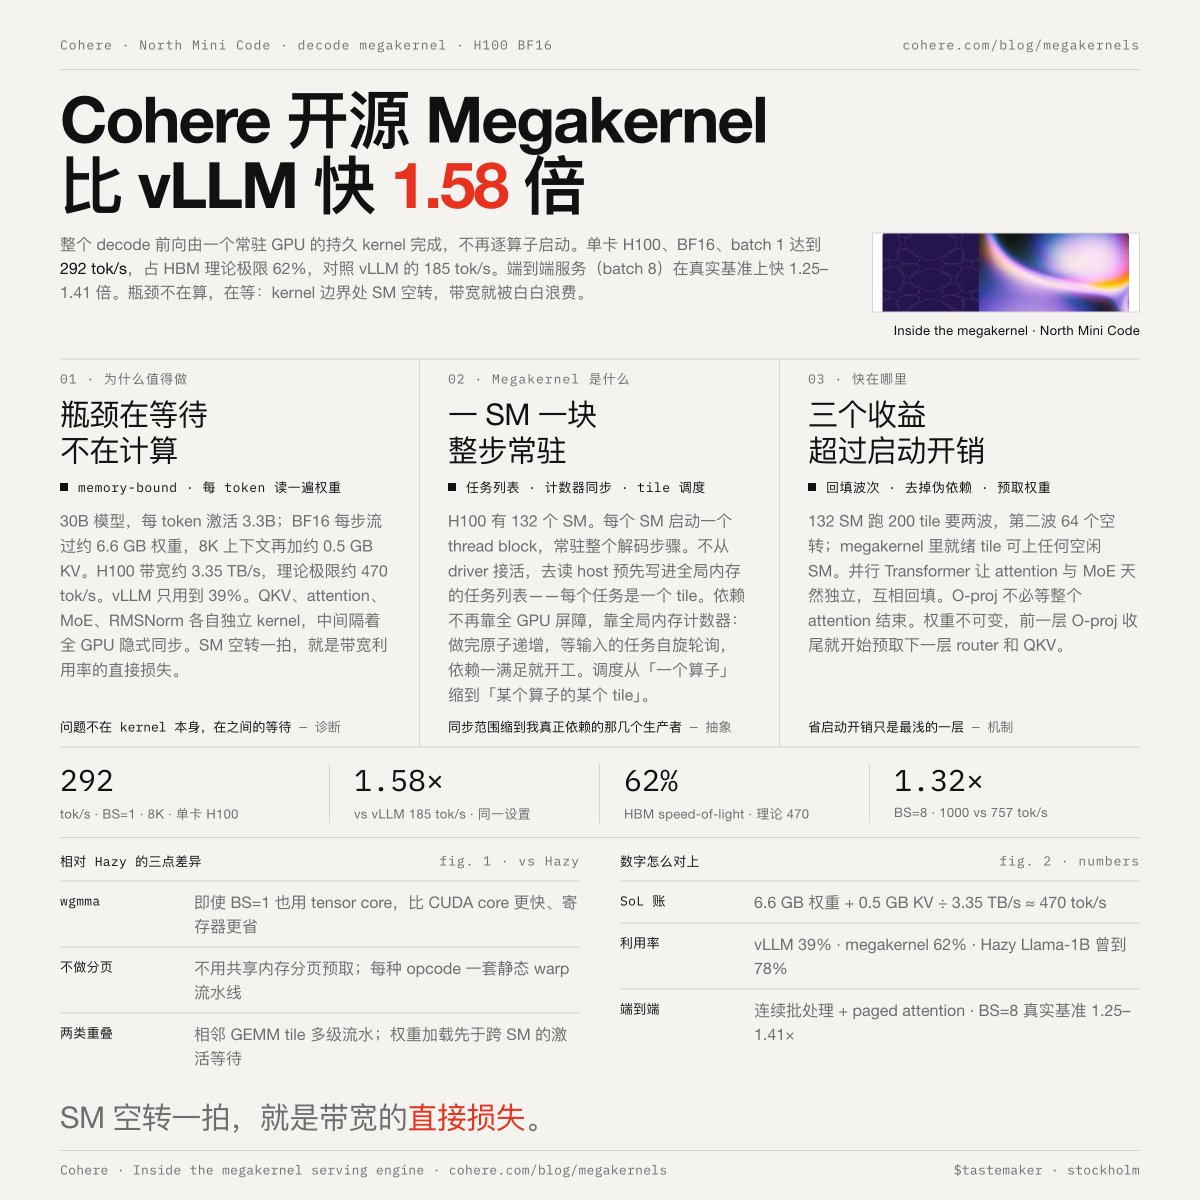
Cohere开源了一个用于大语言模型推理的解码Megakernel服务系统。在单块H100 GPU上,使用BF16精度,批大小为1时达到292 tok/s(达到H100带宽限制的62%),比vLLM(185 tok/s)快1.58倍。在实际基准测试中,批大小为8时的端到端服务速度提升1.25至1.41倍。该系统在每个SM上使用持久化内核,从全局内存队列读取任务,消除了内核启动开销和粗粒度同步。关键改进包括:填补波量化间隙、通过细粒度计数器消除虚假依赖、以及激进权重预取。Cohere为其30B参数的North Mini Code模型构建了该系统。
Key insights
Megakernel设计大幅提升解码吞吐量
Cohere的开源Megakernel系统在每个SM上保持一个持久线程块用于整个解码步骤。任务从主机写入的全局内存队列中获取。同步使用原子计数器而非全GPU屏障。这消除了内核启动开销,减少了波量化导致的利用率不足,并消除了虚假依赖。在H100上,批大小为1的解码达到292 tok/s,比vLLM的185 tok/s快1.58倍。
性能提升不仅限于内核启动节省
三个更深层次的机制贡献了性能提升:(1)当内核瓦片数量不能均匀分配SM数量时,填补未使用的SM周期;(2)消除一个输出等待整个内核完成的虚假依赖;(3)在激活准备就绪之前预取不可变权重。Cohere的系统即使在批大小为1时也使用张量核心(wgmma),避免了共享内存分页错误,并实现了多级流水线重叠。
专为Cohere的30B North Mini Code模型构建
该系统专为Cohere的North Mini Code模型设计,该模型拥有300亿参数。每个token激活33亿参数,需要约6.6 GB的BF16权重,加上8K上下文约0.5 GB的KV缓存。H100的HBM带宽约为3.35 TB/s,理论极限约为470 tok/s。vLLM仅达到该值的39%(185 tok/s);Cohere的Megakernel达到62%(292 tok/s)。