
DeepSeek 发布 V3.2 / V3.2-Speciale
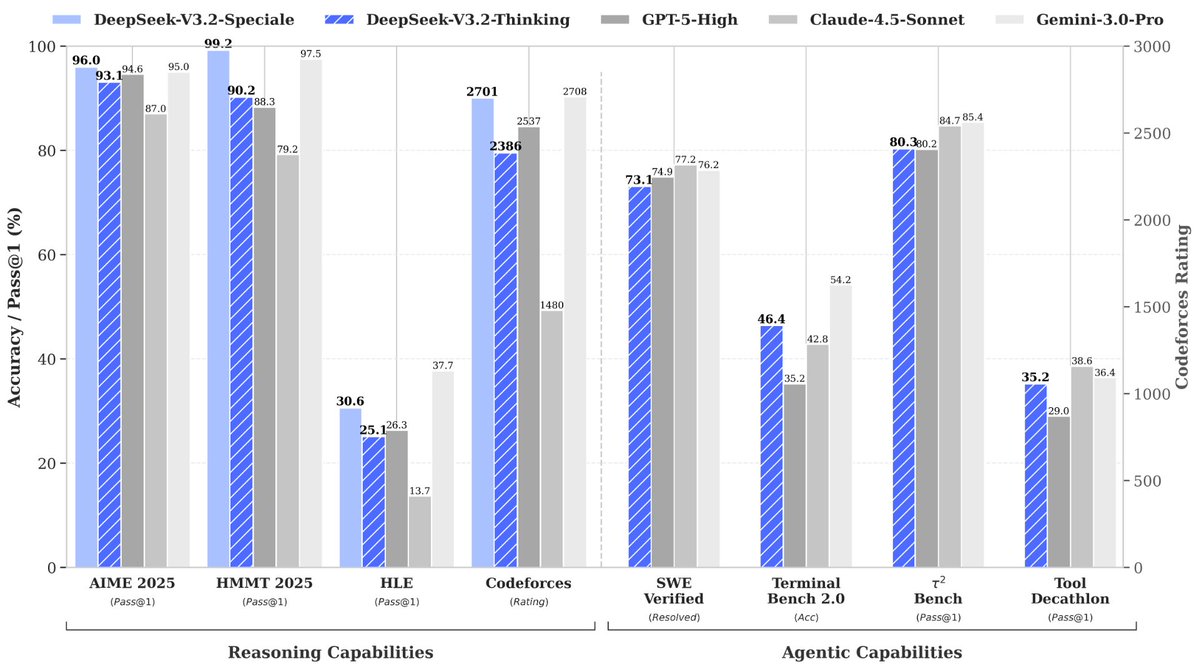
DeepSeek 在 2025-12-01 发布 V3.2 及增强版 V3.2‑Speciale。 - 发布 DeepSeek V3.2 正式版,主打高效推理与 Agent 能力 - 引入稀疏注意力(DSA),优化长上下文并降低计算复杂度 - 首次实现“思考过程中使用工具”,支持思考与非思考双模式调用工具 - 在大规模 Agent 任务合成中提升泛化,集成推理进工具调用场景 - 团队用 1800+ 复杂任务环境与 8.5 万条“难答易验”指令训练新模型 - 相较 V3.1 输出更短、速度更快、算力消耗更低 - 发布长思考增强版 DeepSeek‑V3.2‑Speciale,融合 DeepSeek‑Math‑V2 的定理证明能力 - Speciale 在多场国际竞赛中取得成绩(包括 IMO、CMO、ICPC、IOI 的榜单记录) - 官方称 V3.2 评估接近 GPT‑5,仅次于 Gemini 3 Pro;Speciale 在竞赛中表现卓越 - 官网、App、API 已统一上线 V3.2,并新增 Chat Template 与 developer 角色支持“thinking with tools” - API 新增 Claude Code 支持;官网/应用/API 均已升级为正式版 - DeepSeek‑V3.2‑Speciale 仅开放研究用途,支持“思考模式”但不支持工具调用 - Speciale 最长输出可达 128K tokens,免费测试到 2025-12-15 - 发布包含模型下载/访问链接(多条公开链接) - 多篇介绍帖配图并展示模型能力与评测结果
Key insights
DeepSeek 发布 V3.2 并引入稀疏注意力与长上下文优化
DeepSeek 在 2025-12-01 发布 V3.2 正式版,主要改进包括引入稀疏注意力机制(DSA)以在保证性能的同时降低计算复杂度,并针对长上下文场景做出优化。官方评估显示 V3.2 相较上一代输出更短、响应更快、算力消耗更低,官网、App 与 API 已统一上线正式版。相关帖子列出了模型下载与访问链接,展示配图与评测摘要。
V3.2 首次实现“思考过程中使用工具”的 Agent 能力
DeepSeek‑V3.2 实现了模型在“思考链”中自主决定并调用外部工具的能力:在推理过程中可选择上网检索、调用代码解释器或绘图验证等工具,从而在复杂交互环境中完成多步问题解决。团队通过大规模 Agent 任务合成训练提升泛化,且模型在未对测试工具做专项训练的情况下也达到了开源模型最高水平。
DeepSeek‑V3.2‑Speciale 融合数学证明模块并在竞赛中取得高排名
DeepSeek 同步发布 V3.2‑Speciale 增强版,融合此前的 DeepSeek‑Math‑V2,用于长思考与定理证明。Speciale 在多篇报道中被列出在 2025 年 IMO、CMO、ICPC World Finals 与 IOI 等国际竞赛中的成绩清单,包括 IMO 金牌、CMO 金牌、ICPC 人类选手第二名与 IOI 名次等不同记录。Speciale 被标注为研究用途版本,支持超长思考链但不支持工具调用。
训练方法与数据:1800+ 复杂环境与 8.5 万条验证式指令
DeepSeek 团队为 V3.2 设计了新的训练方式,模拟 1800 多个复杂任务环境,构造 8.5 万条“难回答但易验证”的指令,目的是让模型学会自我推理而非简单复述已有知识。这一训练方式被用于评估模型在未见任务上的举一反三能力,并在官方评测中呈现出较强泛化表现。
产品与发布细节:API 支持、Chat Template 与开放策略
发布信息显示,官方同步更新 Chat Template 以支持 thinking with tools 能力,并新增 developer 角色用于搜索代理。API 增加了 Claude Code 支持。DeepSeek‑V3.2‑Speciale 为研究用途,仅提供思考模式对话,不支持工具调用;Speciale 的最大输出可达 128K tokens,且提供免费测试期至 2025-12-15。多条帖子包含模型访问链接与展示图。
社区与舆论:竞赛成绩引发对实际应用价值的讨论
多篇帖子报道 Speciale 在国际竞赛中取得优异成绩,同时有用户提出竞赛金牌模型与普通用户实际场景价值的讨论,强调需要在真实世界测试出经济价值的 use case。相关评论提到不同模型的最强 use case(写作、agentic 搜索、知识漫画等),并呼吁其他团队公开其竞赛成绩模型。