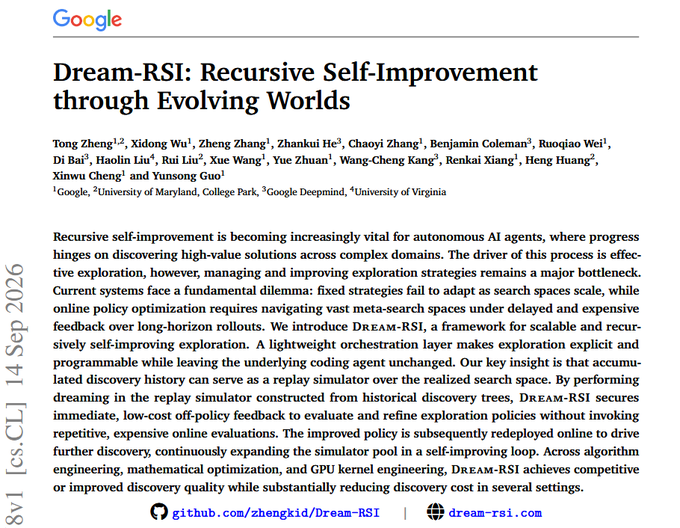
谷歌和DeepMind的Dream-RSI通过回放过去的发现来测试探索策略,提升质量并将智能体调用减少多达162倍。
2026-09-30 01:08:43 UTC Dream-RSI通过递归自我改进将智能体调用减少162倍 谷歌和DeepMind的Dream-RSI通过回放过去的发现来测试探索策略,提升质量并将智能体调用减少多达162倍。 Source posts Original post by @FinanceYF5 on X