
Gemini 3 系列表现与使用反馈
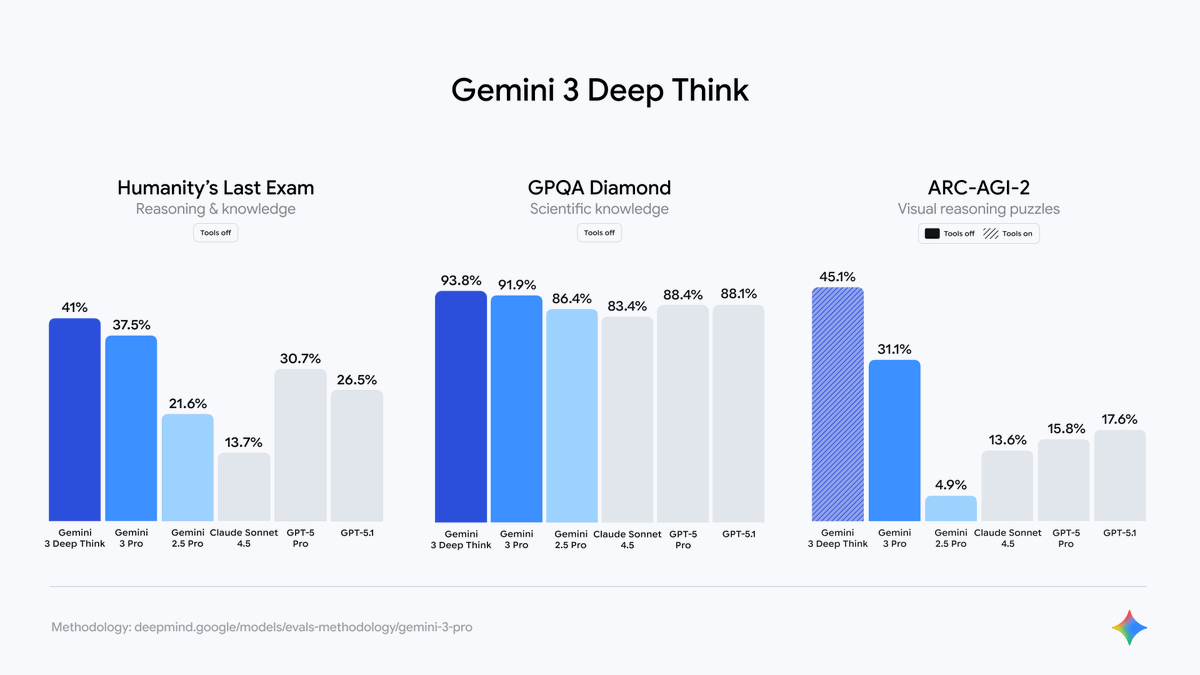
多名用户报告 Gemini 3.0 Pro 在“思想伙伴”与搜索质量上存在分歧。- Yuchen Jin 报告 Gemini 3 Deep Think 超过 Gemini 3 Pro。- 提供的基准分数:Humanity’s Last Exam 41%。- 提供的基准分数:ARC-AGI-2 45.1%。- 有观点称自 Transformer 之后 Google 重新夺回 AI 领先地位(引用上述分数)。- 多位用户认为 Gemini 3.0 Pro 是优秀的“思想伙伴”。- 用户示例:通过 deep-think prompt 获得高质量思维引导与回答。- 多位用户列出 Gemini Pro 优势:多模态能力、能直接读取 YouTube 链接。- 多位用户列出 Gemini Pro 优势:长上下文支持、输出长度、与 Google 搜索集成。- 有用户指出 Gemini 搜索与回答仍存在严重幻觉问题。- 有用户认为 gemini search 质量低于 ChatGPT Search,Deep Research 与 Deep Think 功能被混淆。- 有用户日常大量使用 Gemini,写代码仍偏好 Codex / ChatGPT 订阅。- 有用户提到订阅选择:Gemini App 使用体验不及 AI Studio,Gemini 3.0 Pro 仍有免费层。- 有用户示例:Gemini 可用于将复杂央行与财政知识点整合成动画说明的尝试。
Key insights
Gemini 3/Deep Think 被多位用户评为优秀“思想伙伴”
多位用户在不同测试与日常使用中表述,Gemini 3.0 Pro 或其 Deep Think 模式在引导思考、展开深层次讨论与生成长文本方面表现突出。用户示例包括使用简单提示“deep-think this”获得高质量、结构化的思路演化建议;部分用户基于数年 LLM 实践,将 Gemini 3.0 Pro 评为最佳思想伙伴并建议每日对话以提升思考效率。
基准数据与性能声明
部分用户引用测试分数支持 Google 领先论断: 有用户引用具体基准数据来支持对 Gemini 的性能判断:Humanity’s Last Exam 得分 41%,ARC-AGI-2 得分 45.1%,并以此断言自 Transformer 以来 Google 在 AI 领域已重新取得领先。该论断基于用户公布的分数与模型比较。
搜索与检索功能仍存在幻觉与质量问题
多位用户在对比测试中指出,尽管 Gemini 3.0 Pro 在搜索能力上较之前版本有所改进,但仍存在严重幻觉,搜索结果质量被认为低于 ChatGPT Search。用户描述了 Gemini 将 Deep Thinking 模式与 Deep Research 功能混淆导致错误回答的具体现象。
Gemini Pro 的具体优点:多模态、长上下文、Google 搜索集成
多条用户反馈列举 Gemini Pro 的实际优势:多模态支持(包括直接读取 YouTube 链接)、长上下文与更长输出、与 Google 搜索的集成、写作表现良好以及较少的使用限额。部分用户称这些功能使 Gemini App 在某些场景下优于替代工具,但仍有人偏好在某些任务使用 AI Studio 或其他模型。
工具选择与订阅决策:用户混合使用多款大模型与服务
用户表述呈现混合订阅行为:一些用户表示无法完全停止订阅 ChatGPT 与 Claude,同时日常最多使用 Gemini;也有用户因 Gemini App 不如 AI Studio 而暂不订阅 Gemini Pro。写代码方面,不少用户仍优先使用 Codex 或共享 ChatGPT 订阅。
Gemini 在复杂知识可视化上的尝试与用户感受
有用户尝试让 Gemini 3 将复杂金融与货币政策知识点整合到同一动画或可视化叙述中,并表示模型在此类任务上能力强。该反馈体现用户在探索将 Gemini 用于高复杂度知识整合与呈现的场景。