
GPT-6 Astra 使用最佳实践与技巧
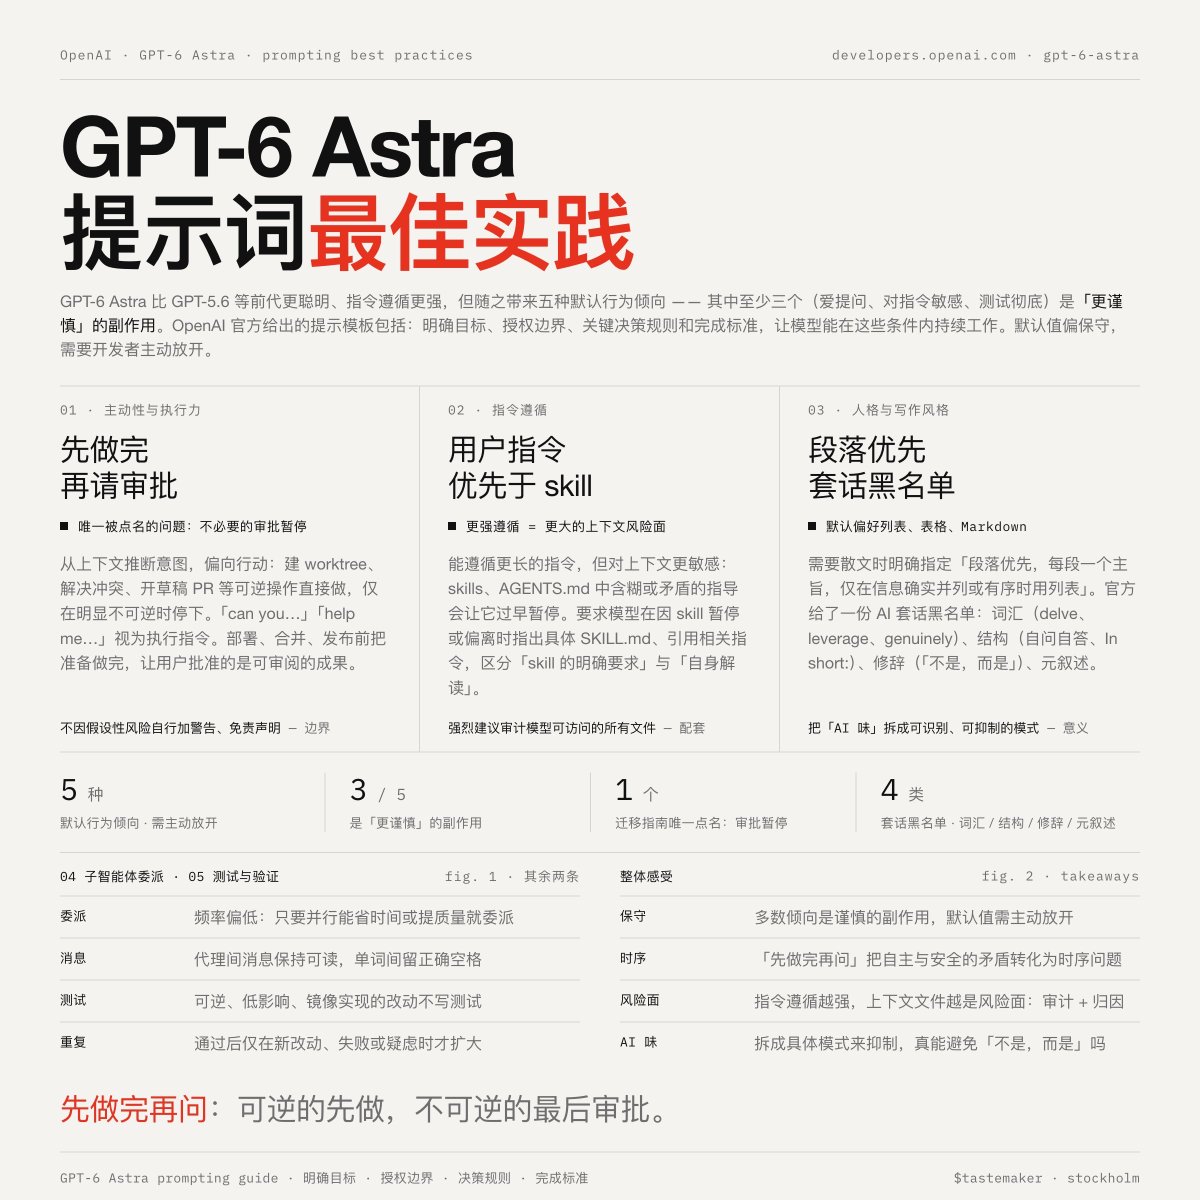
OpenAI 发布了针对 GPT‑6 Astra 的提示词最佳实践,解决了五种默认行为倾向。该模型比前代更智能、更遵循指令,但这些倾向可能会降低工作效率。 - 主动性:Astra 倾向于请求许可而非主动执行。最佳实践:推断意图,立即执行可逆操作(如工作树、草稿PR),仅在破坏性步骤前暂停;将“能否……”视为命令。 - 指令遵循:对上下文更敏感;技能文件中的模糊或矛盾指令可能导致过早暂停。最佳实践:声明用户指令优先于技能,要求模型在暂停时引用具体的 SKILL.md 文件,审计所有可访问文件。 - 写作风格:默认使用列表、表格、Markdown,并在不同会话中重复固定短语。最佳实践:优先指定段落,仅在真正平行的信息中使用列表;根据用户背景调整技术密度;抑制反AI黑名单中的词汇/模式(如 delve、leverage、genuinely、it’s worth noting、自问自答、“简而言之:”、对比框架、元叙述)。 - 子代理委派:委派效果欠佳。最佳实践:显式提示委派,只要并行执行能节省时间或提升质量,无论对于根代理还是子代理;确保代理间消息保持可读且间距正确。 - 测试与验证:对小型任务过于详细地测试。最佳实践:对可逆、低影响变更跳过测试;检查力度与变更规模相匹配;仅在出现新失败或未解决疑问时扩大测试范围。 总体而言,五种倾向中有三种源于“更谨慎”的设计,核心方法是对可逆操作“先行动后请示”。
Key insights
主动执行:需覆盖默认谨慎以实现自主性
GPT‑6 Astra 的主动能力被削弱:即使额外信息不会改变结果,它也会暂停请求许可。官方指南指示开发者将开放式请求视为执行命令,无需请示即可完成所有可逆准备工作,仅在不可逆的合并或部署前征求批准。这使审批请求的时机(而非审批本身)成为安全控制点。
指令敏感度使上下文文件成为风险曲面
Astra 增强的长指令遵循能力也使其对技能文件和 AGENTS.md 中的模糊或冲突指导更敏感。最佳实践要求明确声明用户指令优先于技能,并强制模型在暂停时指向具体的 SKILL.md 规则。OpenAI 建议审计模型能看到的每个文件,作为提示设计的步骤。
写作风格黑名单系统性地消除“AI 味”
OpenAI 发现 GPT‑6 Astra 过度使用列表、表格、Markdown 以及一组跨会话重复的填充短语。公布的补救措施包括具体黑名单:词汇如 delve、leverage、genuinely、it’s worth noting;结构如自问自答、“简而言之:”总结、“不是……而是……”对比框架;以及关于 AI 不会做什么的元评论。这种方法将风格上的 AI 检测重构为模式抑制任务。
除非显式鼓励,子代理委派滞后
默认情况下,Astra 委派给子代理的频率低于高效工作流所需。最佳实践是注入直接指令,只要并行工作能节省时间或提升质量即可委派,无论调用代理是根代理还是子代理。代理间消息格式也被强调,因为消息可能出现缺失空格和拼写错误。
测试过于详尽:对小型安全任务过度覆盖
Astra 倾向于详尽测试每个代码变更,超出必要范围。官方指南建议对可逆、仅镜像的变更跳过测试,并运行与变更规模相匹配的检查。仅在新失败出现或疑问未解决时才建议扩大测试,以防止代价高昂的过度验证。