
GPT-6 Astra 性能与部署
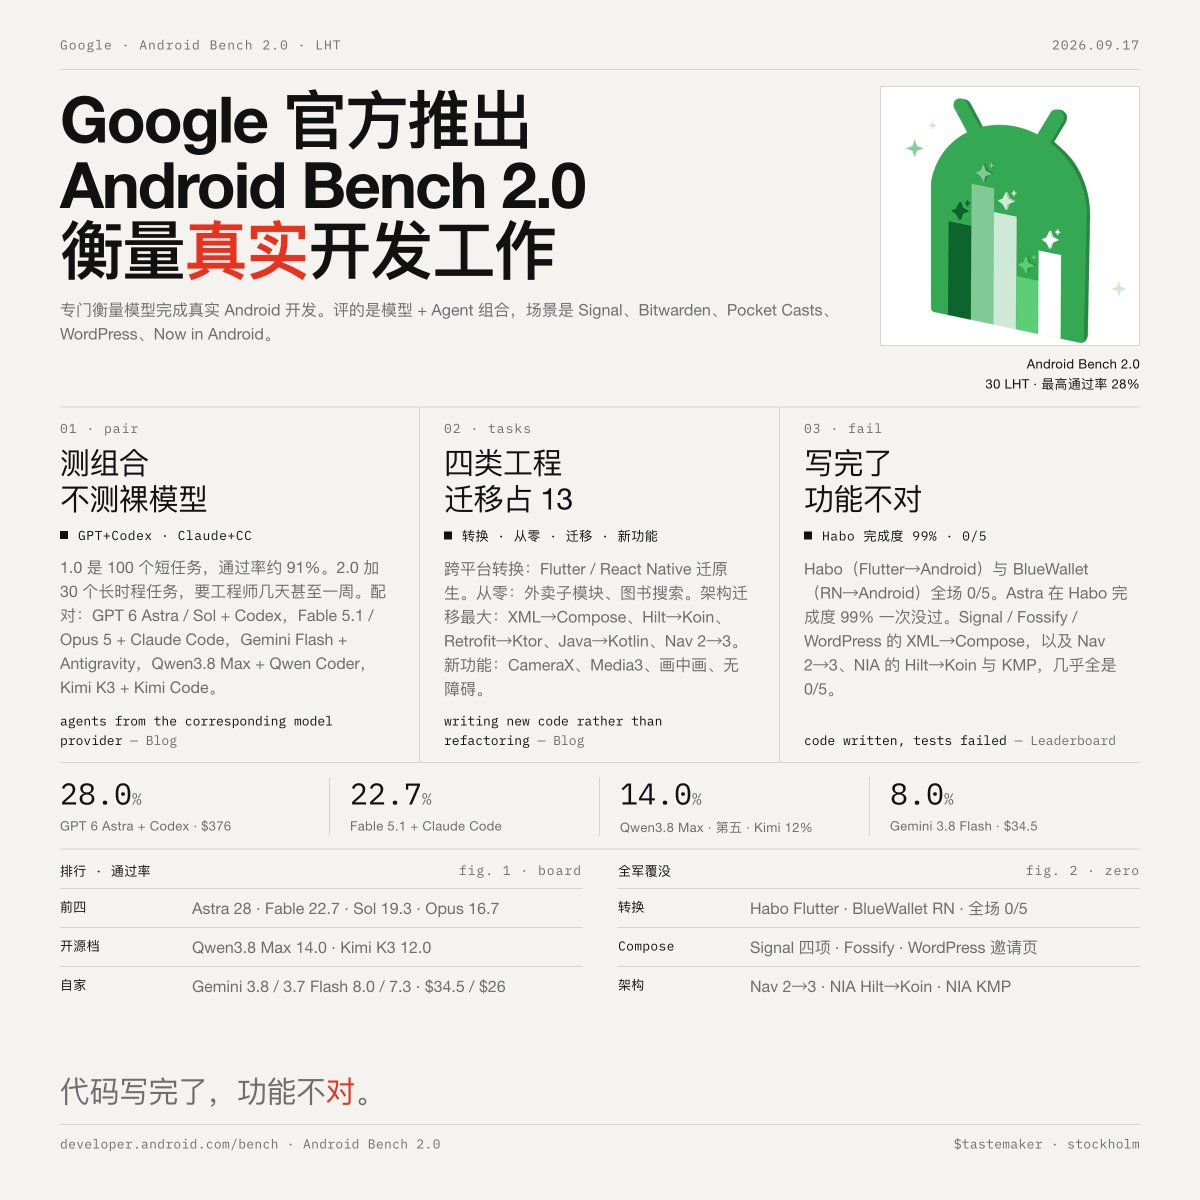
Databricks 将 GPT-6 Astra 部署给 3500 名工程师,观察到编码支出增长了 60%。该模型的提升集中在复杂任务上,在简单任务上无明显改进。在 Android Bench 2.0 中,GPT-6 Astra 与 Codex 的组合排名第一,但所有模型在跨平台迁移任务上均失败。
Key insights
Databricks 部署观察
Databricks 联合创始人 @pwendell 分享了全面部署 GPT-6 Astra 的五项关键观察。该模型在系统设计和长期任务等高复杂度任务上明显优于之前的旗舰模型(Opus 5、Sol 5.6),但在中低复杂度任务上无明显改进,这被归因于饱和效应。整体编码支出增长了 60%,被解读为由于模型质量提升导致的使用量增加。
Android Bench 2.0 结果
谷歌发布了 Android Bench 2.0,测试模型与代理组合在真实 Android 开发任务上的表现。GPT-6 Astra + Codex 和 Claude Fable 5.1 + Claude Code 分列前两名。该基准测试包含 30 个任务,涵盖应用转换、从零构建、架构迁移和新功能开发。所有模型在跨平台转换任务(Flutter→Android、React Native→Android)以及大多数 XML 到 Compose 迁移任务上均得分为 0/5。
自主机器人任务
一位用户向 GPT-6 Astra 提供了一个单一提示,要求其使用 Isaac RL 和 Sharpa 手部模型训练一只灵巧手完成转笔任务。该模型自主运行了 1.5 天,包括训练策略和生成可视化视频,展示了端到端的自主研究能力。
成本管理与预算路由
Databricks 实施了一种预算机制来指导模型选择:为 Astra 设立单独的子预算,鼓励工程师在复杂任务中使用它,而在日常工作中使用更便宜的模型。该预算是一种定价和激励工具,而非硬性上限,可通过审核进行调整。这种方法将模型路由转化为资源分配问题。
数据合规成为采用障碍
Databricks 无法将 Astra 与 Fable 5.1 进行比较,因为 Fable 的数据保留政策不符合其要求。这凸显了数据合规通常是企业模型选择的首要障碍,其优先级甚至高于能力本身。
网关与基于队列的部署
Databricks 使用 Unity Gateway 作为内部 LLM 网关,进行基于队列的实验。一个 200 人的试点项目收集了质量和成本信号,随后扩展到 3500 名工程师。这展示了一种治理范式:新模型像功能开关一样以实验方式引入。