
Hugging Face 发布 tokenizers v1,速度大幅提升
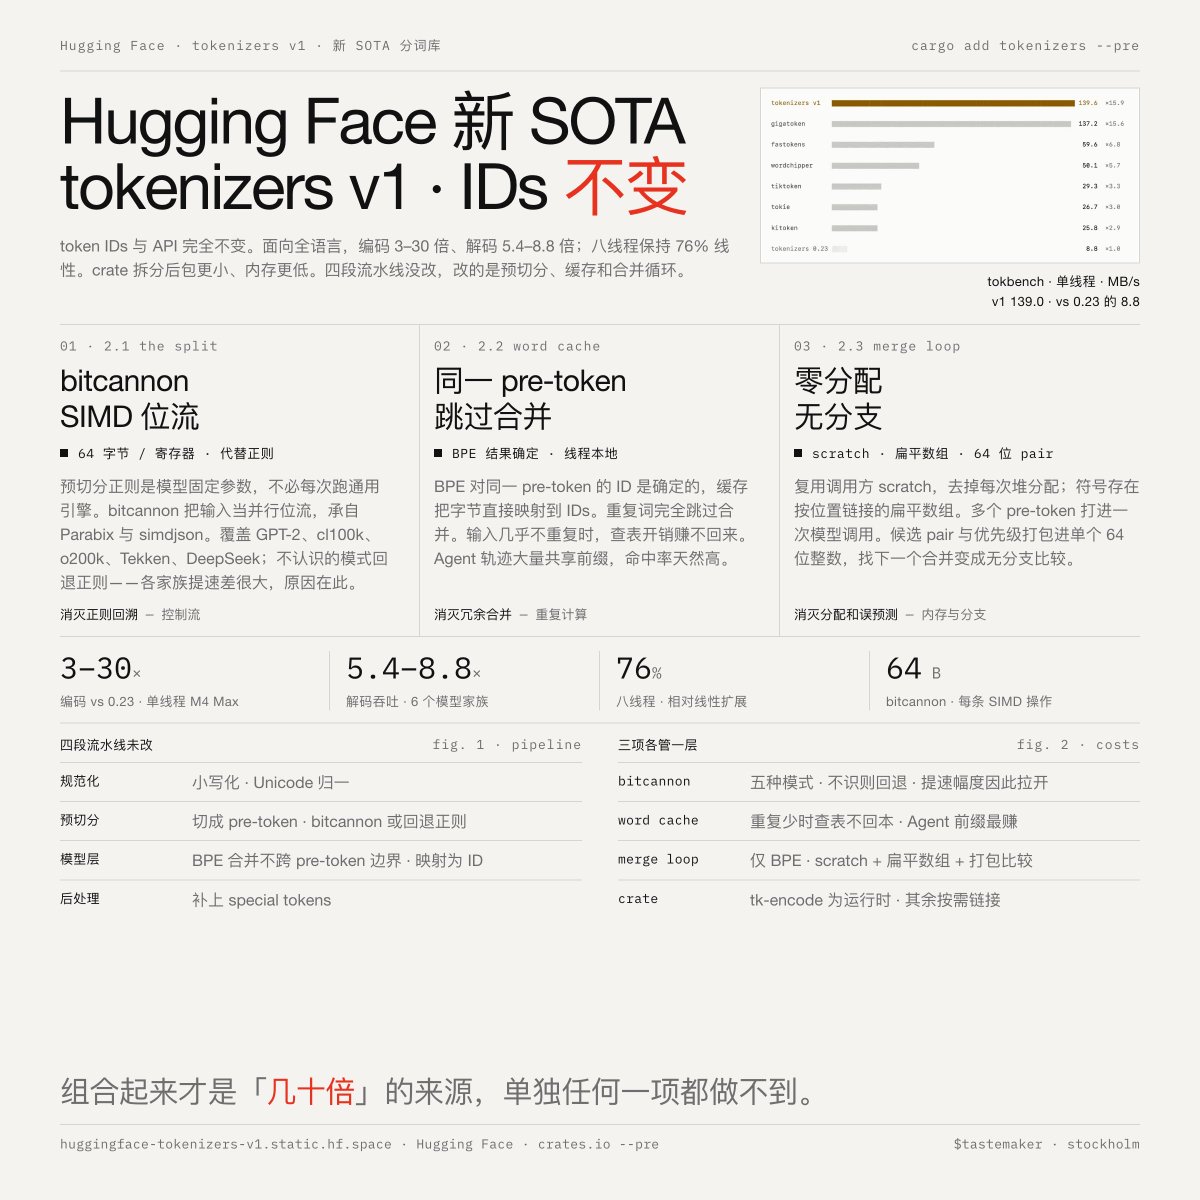
Hugging Face 发布了 tokenizers v1,这是一个新的分词库,在保持 API 不变的情况下,将编码速度提升了 3-30 倍,解码速度提升了 5.4-8.8 倍(适用于所有语言)。速度提升源于三项核心技术:基于 SIMD 的 bitcannon、针对重复词元的词缓存,以及零分配的合并循环。
Key insights
Bitcannon 用 SIMD 位流取代正则表达式
bitcannon 技术将输入字节视为通过 SIMD 寄存器并行处理的位流,从而在预分词阶段无需使用通用正则表达式引擎。它涵盖了五种分词模式(GPT-2、cl100k、o200k、Tekken、DeepSeek),并对无法识别的模式回退到正则表达式,这解释了不同模型系列之间速度提升的差异。
词缓存消除冗余的 BPE 合并
线程局部的词缓存将预分词字节映射到词元 ID,从而跳过重复单词的合并计算。这在代理场景中尤为有效,因为许多请求共享共同的前缀,导致缓存命中率很高。仅当重复频繁时,缓存查找的开销才是合理的。
合并循环实现零分配和无分支执行
合并循环优化结合了四种技术:重用调用方提供的临时缓冲区、将符号存储在按位置链接的扁平数组中、将多个预分词批量处理为单个模型调用,以及将每个候选对及其合并优先级打包到 64 位整数中。这消除了堆分配、链表开销和分支预测错误。
三项技术针对不同的瓶颈
这三项核心技术针对不同的成本层:bitcannon 消除了正则表达式回溯(控制流),词缓存消除了冗余合并(重复计算),而合并循环则减少了分配和分支预测失败(内存和分支)。综合效果实现了所报告的 3-30 倍加速;没有任何单一技术能单独实现这一效果。