
Hugging Face 的 tokenizers v1 利用 SIMD 和缓存将分词速度提升 3-30 倍
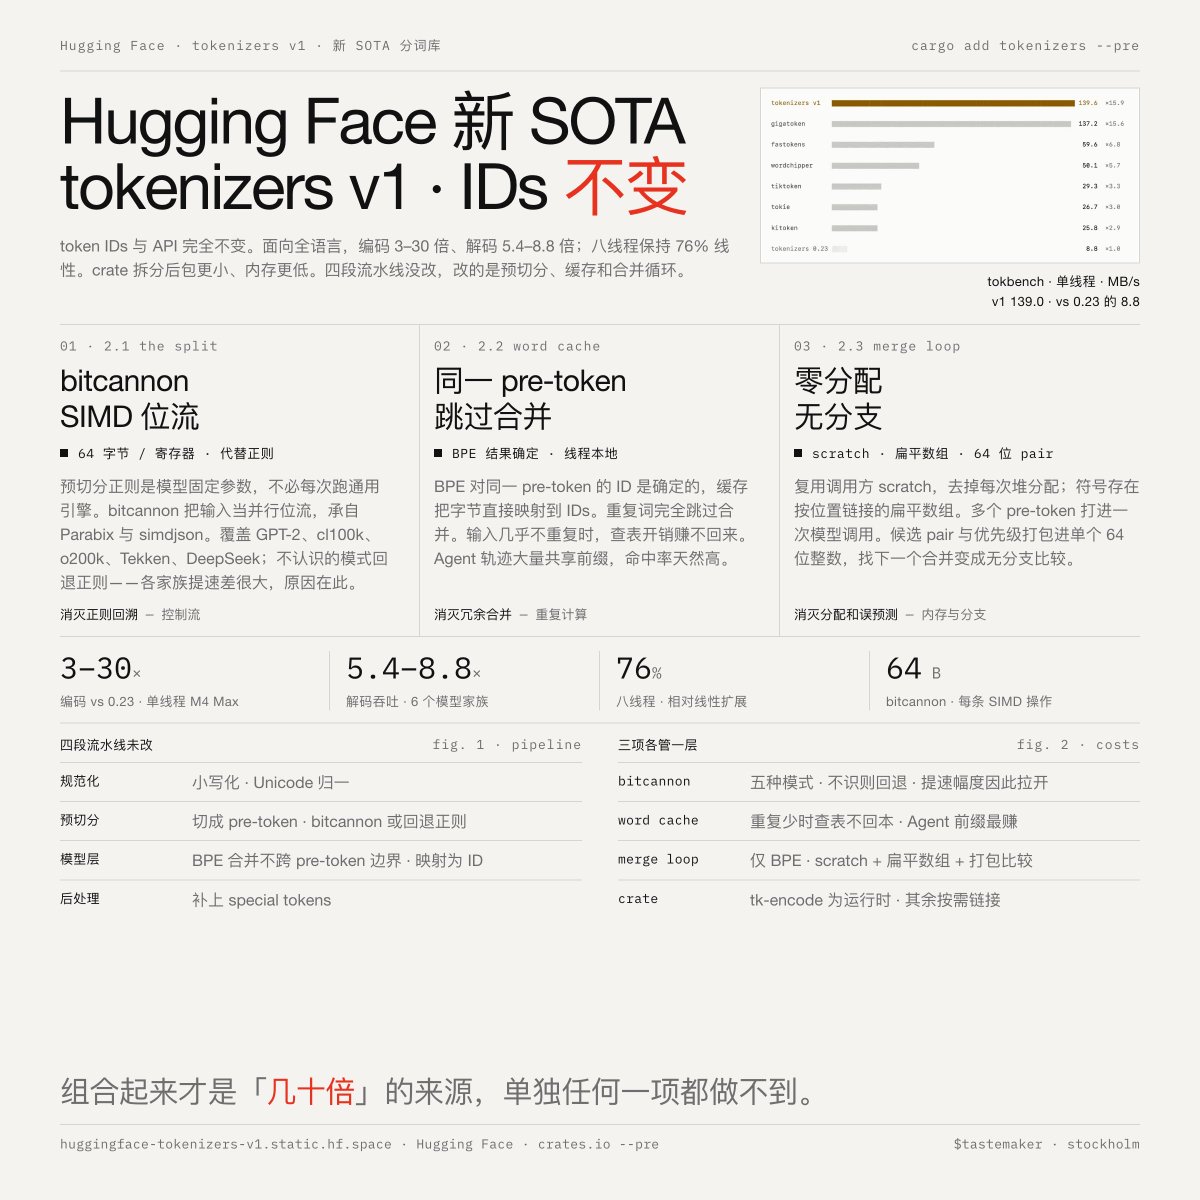
Hugging Face 发布了 tokenizers v1,这是一个新的 SOTA 分词库,可在不改变 token ID 或 API 的情况下,将所有语言的编码速度提升 3-30 倍,解码速度提升 5.4-8.8 倍。其加速来自三项核心技术:bitcannon(基于 SIMD 的预分词)、word cache(BPE 结果缓存)以及零分配、无分支的合并循环。此外,该库还通过 crate 拆分实现了更小的包体积和更低的内存占用。