
HuggingFace发布tokenizers v1,速度显著提升
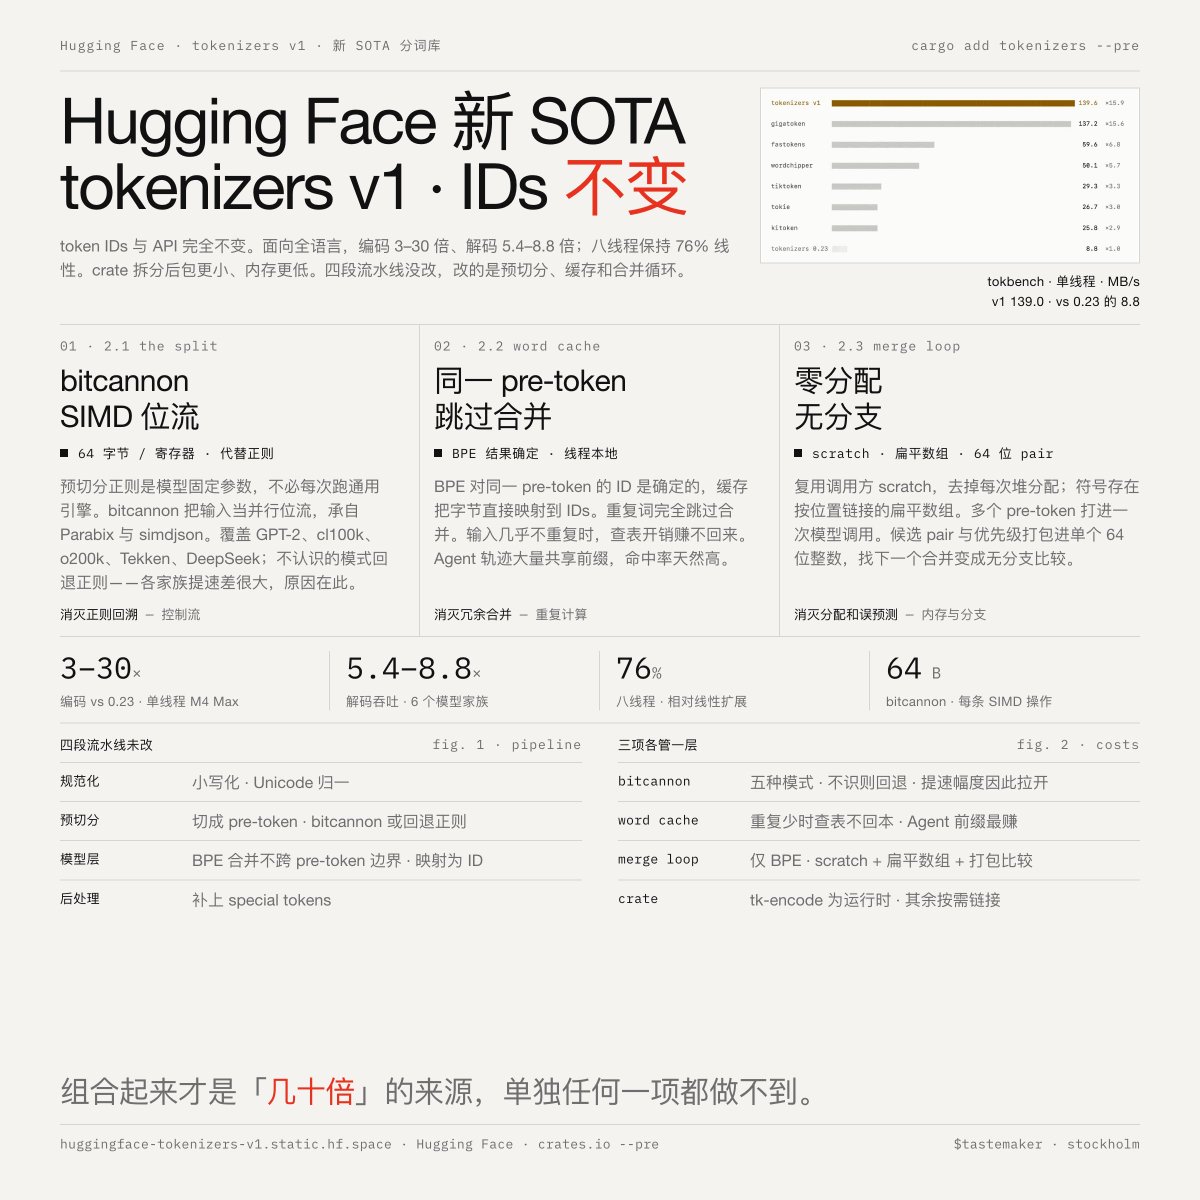
HuggingFace发布了tokenizers v1,这是其分词库的一次重大更新。通过基于SIMD的分割、单词缓存和零分配合并,编码速度提升了3-30倍,解码速度提升了5.4-8.8倍。内存使用量降低了2.8倍,并且该库与之前的版本保持向后兼容,具有相同的token ID和API。
Key insights
三大核心技术驱动性能提升
Tokenizers v1采用了三项关键优化。Bitcannon使用SIMD位流处理替代正则表达式进行预分词,支持五种分割模式(GPT-2、cl100k、o200k、Tekken、DeepSeek),并对未知模式回退到正则表达式。单词缓存在线程本地存储中按预分词缓存BPE合并结果,有利于前缀复用率高的智能体轨迹。合并循环通过将优先级打包到单个64位整数中并重用临时缓冲区,实现了零分配和无分支合并。
跨语言的性能测量
在单线程测试中,tokenizers v1比之前的0.23版本快3-30倍。对于512字节的英文文档,延迟从110微秒降至7微秒。中文吞吐量提升了6.8倍,而印地语和阿姆哈拉语提升了10倍以上。解码速度提升了5.4-8.8倍。内存使用量减少了2.8倍。
向后兼容性与更小的安装包
Tokenizers v1与0.23版本保持完全向后兼容,具有相同的token ID和API。该库使用Rust编写,并提供Python和Node.js绑定。推理和训练模块被拆分为独立的crate,在仅需要推理时减小安装体积。它支持2008年及以后的x86 CPU,并包含针对Apple ARM芯片的特定优化。
单词缓存对智能体和长上下文场景的益处
单词缓存优化对于许多请求共享相同前缀的智能体工作负载尤为有效。在这些场景中,缓存命中率自然很高,从而减少了冗余的合并计算。当输入重复率低时,开销可以忽略不计,因为与BPE合并步骤相比,查找开销非常小。