
HunyuanOCR 开源与 OCR 对比平台
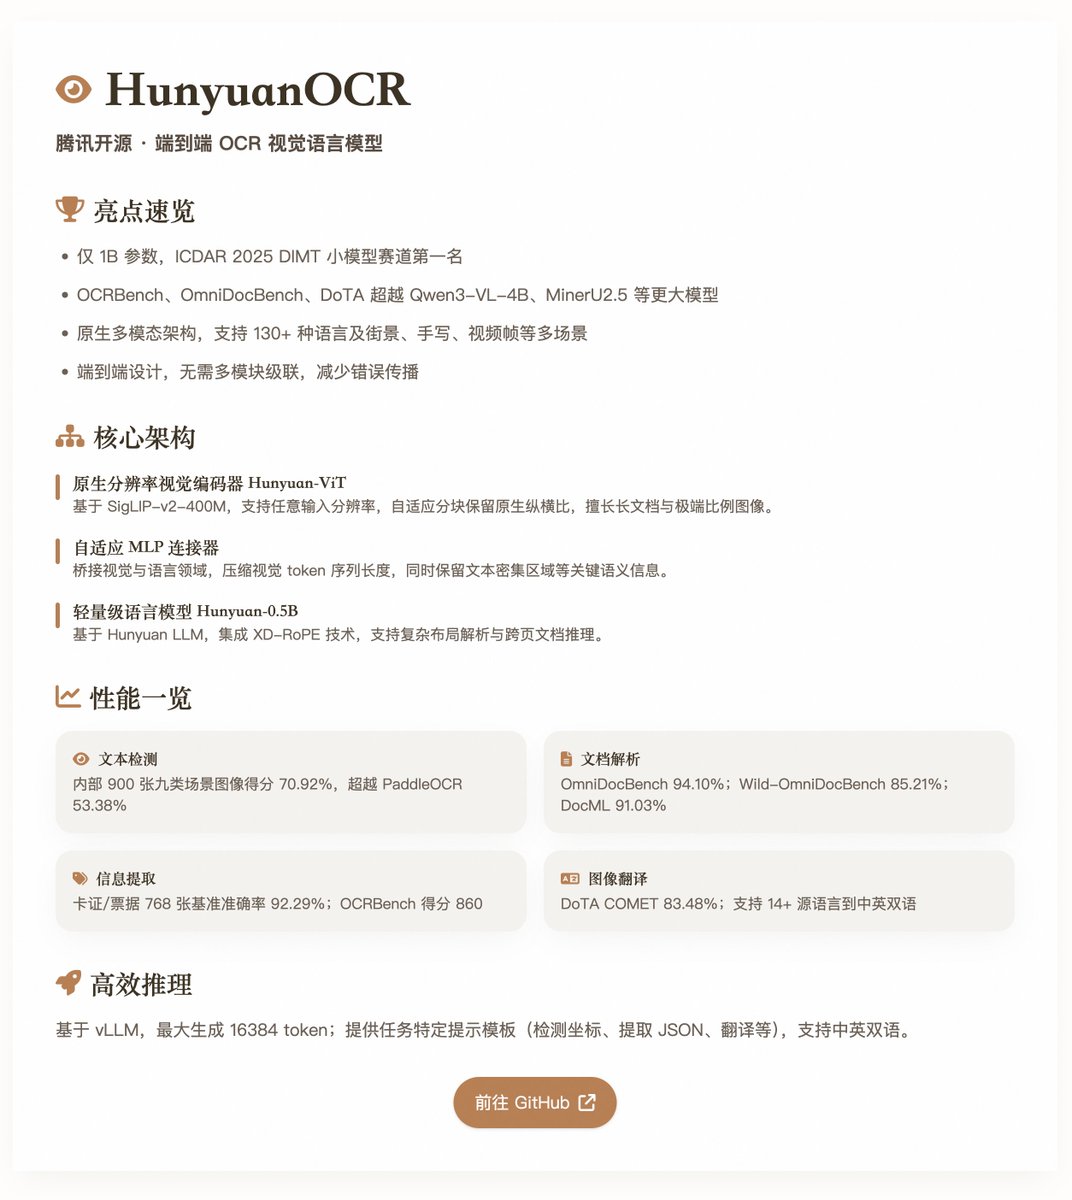
腾讯开源 HunyuanOCR:端到端 OCR 视觉语言模型,参数约 1B,在多项基准取得领先。- 模型由原生分辨率视觉编码器 Hunyuan-ViT(约 0.4B)、自适应 MLP 连接器与轻量级语言模型 Hunyuan-0.5B 构成。- 端到端设计避免模块级联,适用文本检测、文档解析、信息提取、视觉问答与图像翻译等场景。- 训练数据与流程:预训练共 454B token,约 2 亿高质量样本;后训练使用在线强化学习算法 GRPO 与任务特定奖励。- 在 ICDAR 2025 DIMT(小模型轨道)获第一;在 OCRBench、OmniDocBench、DoTA 等基准上超越多更大模型,给出具体评分与准确率指标。- 开源模型与 OCR Arena 平台并行,后者提供真实文档对比测试与可视化差异工具,支持与多款主流模型对战。
Key insights
HunyuanOCR 用 1B 参数实现端到端 OCR 领先表现
腾讯发布 HunyuanOCR,参数规模约 1B,采用端到端视觉语言模型设计以避免传统多模块级联的问题。核心架构包括 Hunyuan-ViT(约 0.4B,原生分辨率编码)、自适应 MLP 连接器以及 Hunyuan-0.5B 轻量语言模块,支持多任务统一建模,能通过自然语言指令完成检测、识别、解析与翻译等流程。
训练与优化策略:大规模 token 预训练与 GRPO 强化微调
模型预训练分四步、总计约 454B token,训练样本约 2 亿条,覆盖多场景与多语言;后训练阶段采用在线强化学习算法 GRPO,并结合任务特定奖励(rule-based 与 LLM-as-a-judge)以提升复杂场景鲁棒性。这些数据与优化管道用于提升长上下文、跨页推理与实际文档解析能力。
基准成绩与实际场景表现领先多模型
HunyuanOCR 在 ICDAR 2025 DIMT(小模型轨道)获得第一,在内部文档解析、文本检测与信息提取等多项基准如 OmniDocBench、OCRBench、DoTA、DocML 等展示优异成绩(列出具体得分与准确率),并在真实场景基准上超越更大规模的 Qwen3-VL-4B 与 MinerU2.5 等模型。
OCR Arena 提供真实文档对比与可视化评测平台
OCR Arena 是专为真实文档设计的交互式 playground,支持实时上传文档并生成视觉差异图、对比表格完整性与提取精度,适用于结构化文件、手写体与扫描图像的现实场景测试。平台能与 Gemini 3、DeepSeek-OCR、GPT-5 等 10 多个模型进行面对面比较,并提供基于用户测试的透明排行榜。