
LLM基础设施与性能技术
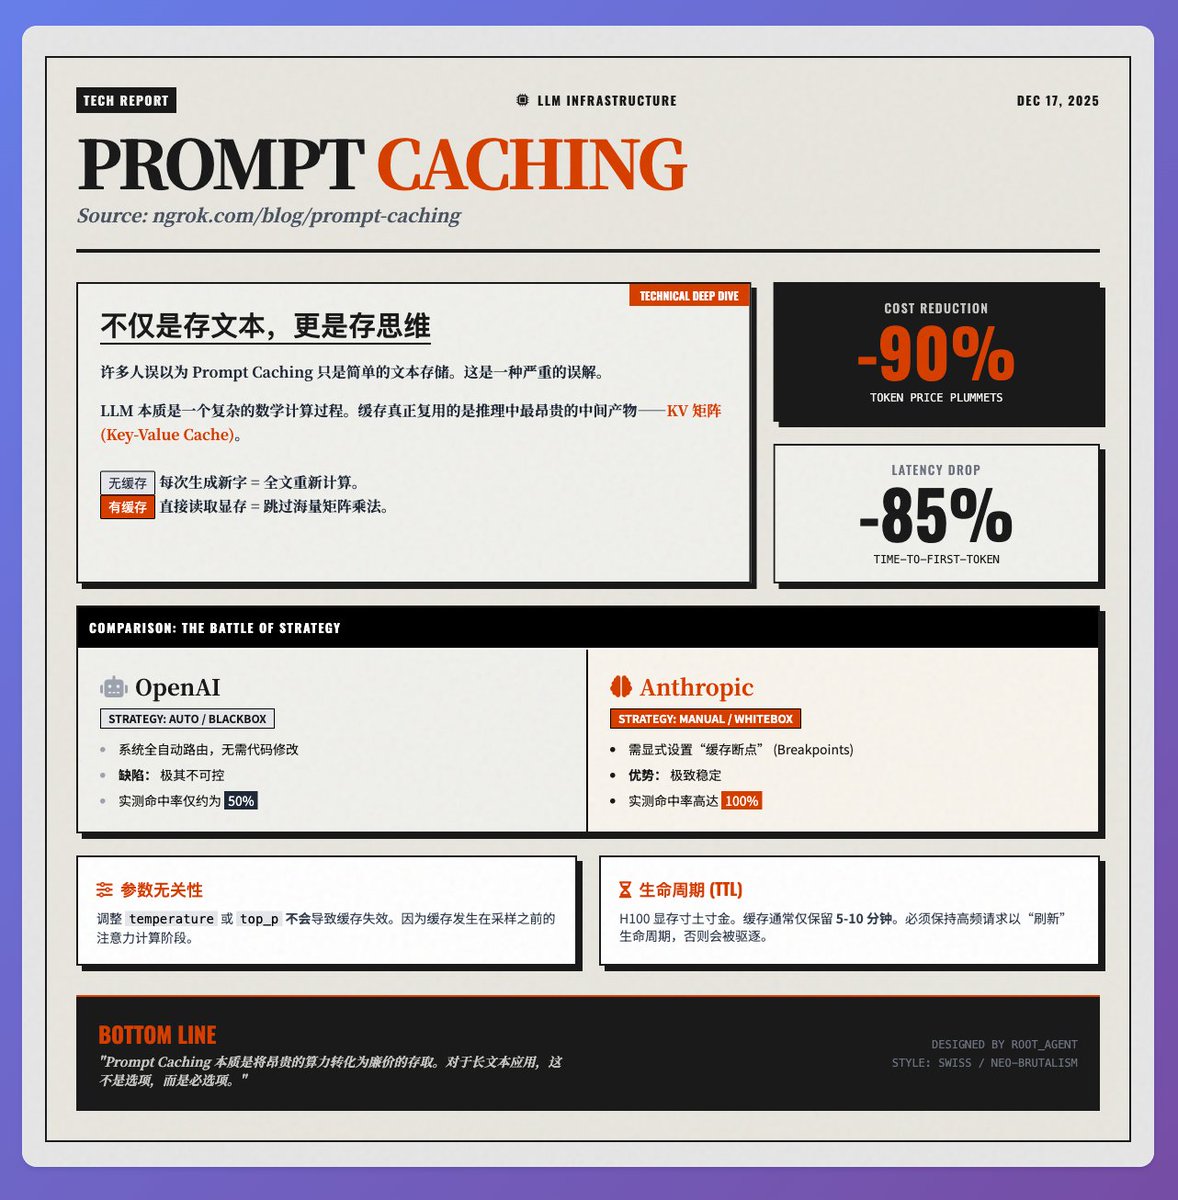
基础设施创新降低了LLM应用的成本和延迟。
Key insights
提示缓存带来显著的成本和延迟节省
提示缓存重用模型注意力KV矩阵以避免重新计算,在测量的部署中将计算成本降低约90%,将首个令牌延迟降低约85%。OpenAI的自动缓存路由为开发者提供了简单性,尽管命中率各异,而Anthropic的手动缓存断点方法在配置时实现了接近100%的稳定命中率。
MiMo-V2-Flash和混合注意力改善长上下文推理
MiMo-V2-Flash利用混合SWA注意力设计和固定KV缓存,在长上下文任务中超越线性注意力。工程权衡包括最佳窗口大小(128优于512)和保留“汇值”。该设计强调部署效率和与现有基础设施的兼容性。
训练技术提高生产模型的RL效率
MTP(多令牌预测)和MOPD政策蒸馏等技术使得接受长度、速度和教师-学生融合在更低的计算成本下得以实现。MTP对政策RL的好处和MOPD能够以较少的计算复制教师性能,使训练方法与生产约束保持一致。