
Meta 发布 SAM 3 与 SAM 3D
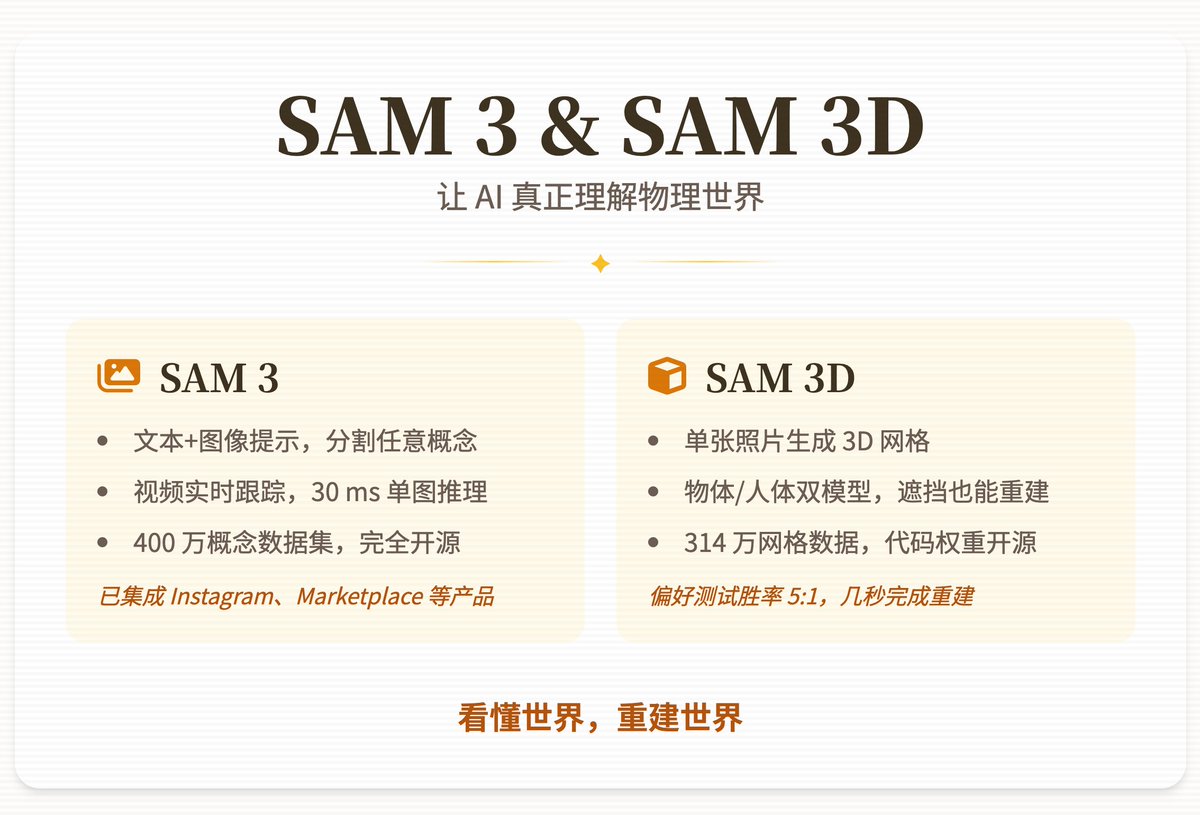
Meta 在 2025 年 11 月 20 日发布了两款新模型,SAM 3 和 SAM 3D。SAM 3 支持点、框和掩码提示,并新增文本和图像示例提示。它实现了开放词汇的概念级分割,能够处理复合概念。SAM 3 在视频中实现实时物体跟踪,支持第一人称眼镜视频等动态场景。它作为多模态大语言模型的视觉工具,与 Llama 等集成。SAM 3 在 SA-Co 基准上比领先模型如 Gemini 2.5 Pro 提升约 2 倍。单张图片(100+ 物体)推理约 30ms(H200 GPU),视频接近实时。它使用超过 400 万个独特概念数据进行训练,采用 AI + 人类混合标注(通过 Llama 3.2v 验证)。所有模型权重、评估数据集(包括 SA-FARI)和微调代码均已开源。SAM 3D 包含 SAM 3D Objects 和 SAM 3D Body 两个子模型,面向物体与人体重建。SAM 3D 能够从单张自然照片生成带纹理、可摆姿势的 3D 网格。它使用“model-in-the-loop”数据引擎:AI 生成粗糙 3D,人工评分/修正,产出约 314 万个网格标注。SAM 3D 采用合成预训练与真实数据多阶段对齐,支持分割掩码与 2D 关键点等交互提示。在人类偏好测试中,SAM 3D 至少以 5:1 的比例胜过现有最佳模型,生成速度为几秒级。两个子模型、权重及新数据集 SA-3DAO、人体参数化模型 MHR 以宽松许可开源。产品集成案例包括 Instagram Edits、Meta AI Vibes 和 Facebook Marketplace 的“View in Room”。
Key insights
SAM 3:开放词汇与多模态提示的统一分割引擎
SAM 3 被定位为统一的图像与视频“任意分割”模型,继承点、框、掩码提示并新增文本提示与图像示例提示,实现开放词汇的概念级分割,能够处理细粒度与复合概念,并能在视频中实现实时物体跟踪与第一人称视频支持;训练基于 400 万+ 独特概念的 AI+人类混合标注流程,性能在 SA-Co 基准上较竞争对手提升约 2 倍,单图推理约 30ms(H200)。
SAM 3D:单张图片生成可交互 3D 网格
SAM 3D 包含 Objects 与 Body 两个子模型,能够从单张自然图像重建物体与人体的 3D 形状、纹理与布局;SAM 3D Body 可在无多视角或深度传感器情况下恢复完整人体姿态和体型,支持遮挡与奇异姿势;重建结果可旋转、缩放与摆姿势,生成速度为数秒,分辨率适中且对遮挡与间接视角具鲁棒性。
Model-in-the-loop 数据引擎实现大规模 3D 标注
SAM 3D 的训练依赖“model-in-the-loop”数据引擎:AI 先生成粗糙 3D,再由人工评分与修正难例,形成近百万乃至数百万规模的高质量标注集(报告中提到共计 314 万个网格);结合合成数据预训练与真实数据对齐的多阶段训练,解决模拟到现实的鸿沟,支撑单图 3D 重建能力。
开源策略与产业落地集成
Meta 将 SAM 3 与 SAM 3D 的模型权重、评估数据集(包括 SA-FARI、SA-3DAO)、微调代码以及人体参数化模型 MHR 等以宽松许可开源;产品层面,Instagram Edits、Meta AI Vibes 和 Facebook Marketplace 的“View in Room”等已集成 SAM 3 功能,应用场景涵盖视频特效、商品 3D 可视化与野生动物监测。
性能与可用性指标
Meta 报告中给出关键指标:SAM 3 在标准基准上优于 Gemini 2.5 Pro、GLEE、OWLv2 等约 2 倍;单图(100+ 物体)推理约 30ms(H200),视频近实时;SAM 3D 在人类偏好测试中以至少 5:1 胜过现有最佳模型,且生成速度为几秒级,支持交互式提示引导重建。
提示交互与多模态工具链价值
SAM 3 支持文本与图像示例提示,能够按用户自然语言或示例图分割“类似的东西”,并能作为多模态大模型(例如 Llama)的视觉工具接入,从而提升复杂视觉推理与下游任务的可控性;SAM 3D 也支持用分割掩码与 2D 关键点等交互提示来引导三维重建过程。