NVIDIA NIM优化为Nemotron模型带来2.78倍并发用户数提升
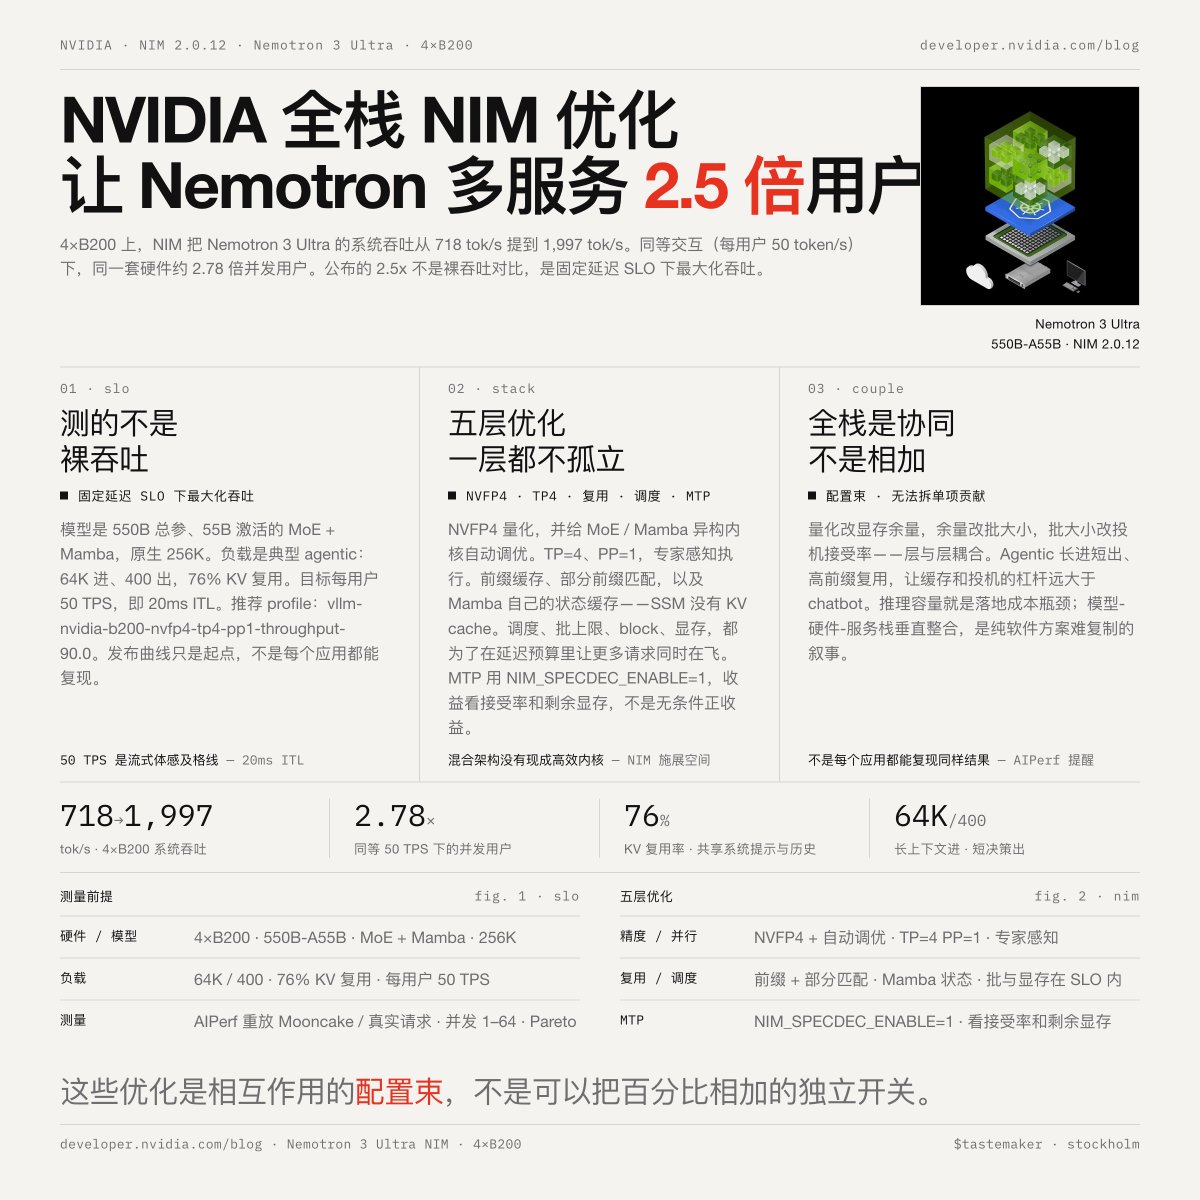
NVIDIA展示了其NIM微服务栈如何在4块B200硬件上优化Nemotron 3 Ultra 550B模型,以服务2.78倍并发用户数,同时保持延迟服务等级协议(SLO)。这一“全栈”优化包括NVFP4量化、MoE/Mamba感知内核调优、前缀缓存以及多令牌预测推测解码,关键洞察在于这些优化相互依赖,无法独立应用以实现累积增益。

NVIDIA展示了其NIM微服务栈如何在4块B200硬件上优化Nemotron 3 Ultra 550B模型,以服务2.78倍并发用户数,同时保持延迟服务等级协议(SLO)。这一“全栈”优化包括NVFP4量化、MoE/Mamba感知内核调优、前缀缓存以及多令牌预测推测解码,关键洞察在于这些优化相互依赖,无法独立应用以实现累积增益。