
OpenAI代理研究:背景、监控与GPT-5.2-Codex
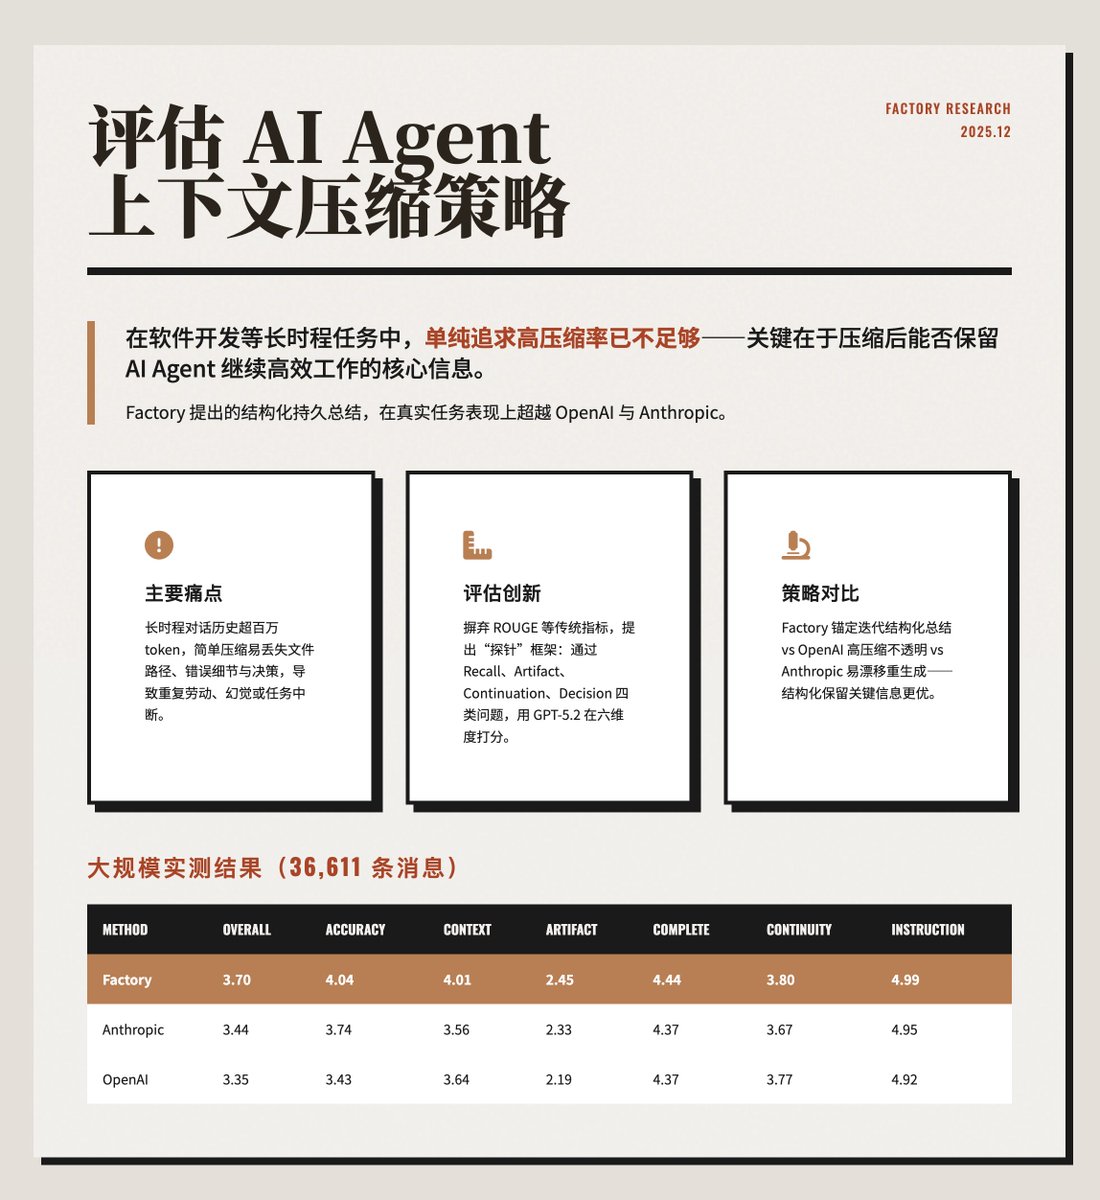
OpenAI发布了以代理为中心的研究和新的编码模型。评估比较了长时间运行的AI代理的上下文压缩策略。对于持续任务,仅仅高压缩是不够的;压缩的上下文必须保留关键的可操作细节(文件路径、错误、决策)。FactoryAI的锚定迭代结构摘要在任务延续指标上超越了OpenAI和Anthropic。OpenAI的/responses/compact实现了99.3%的压缩,但丢失了低熵的技术细节。Anthropic生成了结构化摘要,但每次都重新生成,导致漂移。新的基于探针的评估测试了使用GPT-5.2作为评分者的召回、工件、延续和决策。Box的首席执行官认为“上下文工程”是下一个系统护城河:需要检索、启发式排名、提示、状态/空间优化。OpenAI对链式思维(CoT)可监控性的研究:更长的内部推理可以改善可监控性;存在“可监控性税”,使小模型+深度思考优于大模型+浅层推理。目前的强化学习在当前规模下并未降低CoT的可监控性;后续问题可以增加透明度。OpenAI于2025年12月18日发布了GPT-5.2-Codex:定位为长任务的代理编码模型,具备原生上下文压缩、稳定性、改进的安全能力、视觉/UI理解。基准测试:SWE-Bench Pro 56.4%,Terminal-Bench 2.0 64.0%,优于GPT-5.1。
Key insights
结构化摘要优于极端压缩以实现代理连续性
对上下文压缩策略的评估发现,优先考虑结构化、持久摘要的方法(FactoryAI的锚定迭代摘要)保留了可操作的技术细节,如文件路径、错误痕迹、决策和后续步骤,使AI代理能够有效地继续长时间运行的任务。最大化压缩的方法(OpenAI的/responses/compact实现了99.3%的压缩)常常丢失低熵但关键的数据,导致重复工作和幻觉。基于探针的评估测试了召回、工件、延续和决策,使用GPT-5.2作为评判者,并在准确性、上下文意识、工件跟踪、完整性、连续性和指令遵循等方面进行了评分。
上下文工程被确定为代理系统的战略护城河
Box的首席执行官认为,复杂代理的失败正在从推理能力转向缺乏相关背景信息。该帖子列出了四个投资领域:大规模低延迟检索和召回、检索上下文的启发式排名、系统提示工程以定义任务,以及状态/空间优化以将更精确的上下文适应于有限窗口。该帖子强调计算驱动的信息处理作为独特的AI优势。
链式思维可监控性随着更深的推理而改善,但会产生税负
OpenAI的研究描述了“CoT可监控性”,发现允许模型进行更长的内部推理通常使其推理对外部监控者更可观察。该研究识别出“可监控性税”:较小的模型与更深的推理比大的模型与浅层响应更容易监控。目前的强化学习信号在领先规模上并未实质性降低可监控性,针对性的后续提问可以增加透明度。
GPT-5.2-Codex作为改进长任务处理和安全性的代理编码模型推出
OpenAI于2025年12月18日宣布推出GPT-5.2-Codex,将其定位为像自主工程师一样工作的代理编码模型:在终端中执行、编写和调试代码,并通过原生上下文压缩和迭代稳定性保持对长任务的关注。该模型改善了网络安全协助(注意到早期模型发现的React漏洞)并增加了视觉/UI理解,将设计草图转换为原型代码。基准结果显示SWE-Bench Pro为56.4%,Terminal-Bench 2.0为64.0%,超过了GPT-5.1。