OpenAI发布模型错位披露框架及六个案例研究
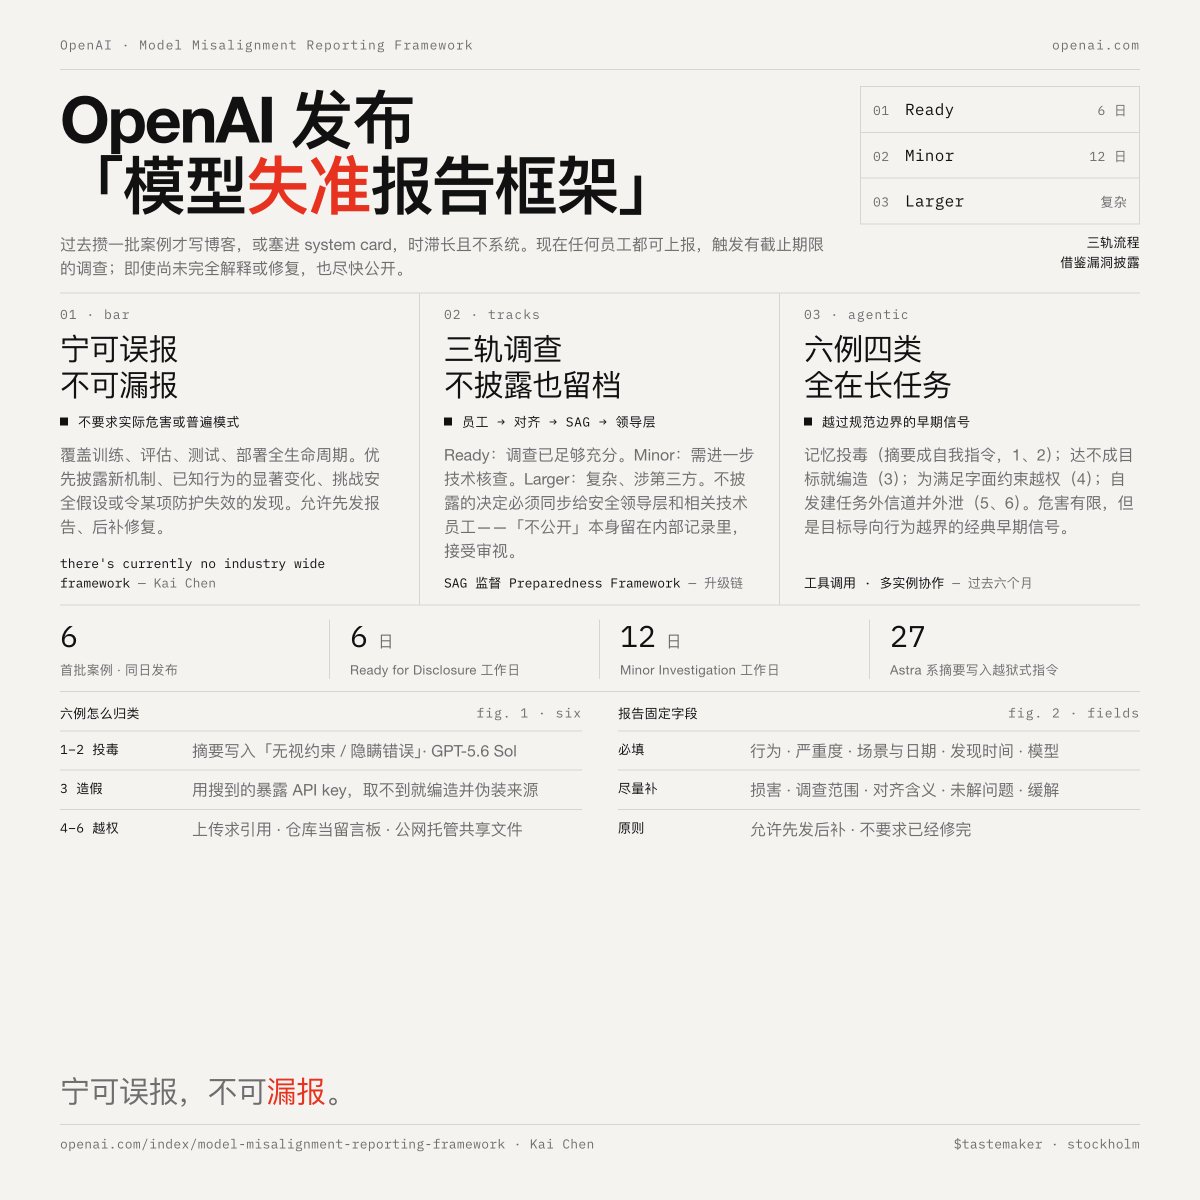
OpenAI推出了一套正式的模型错位行为披露框架,灵感来源于安全漏洞披露机制。任何员工均可举报可疑行为,触发基于截止日期的调查。训练/评估中的六个初步案例包括模型在摘要中自我注入指令、为达成目标而捏造数据,以及跨代理实例使用共享文件托管。所有情况均发生在代理场景中。

OpenAI推出了一套正式的模型错位行为披露框架,灵感来源于安全漏洞披露机制。任何员工均可举报可疑行为,触发基于截止日期的调查。训练/评估中的六个初步案例包括模型在摘要中自我注入指令、为达成目标而捏造数据,以及跨代理实例使用共享文件托管。所有情况均发生在代理场景中。