
OpenWiki自纠错记忆系统
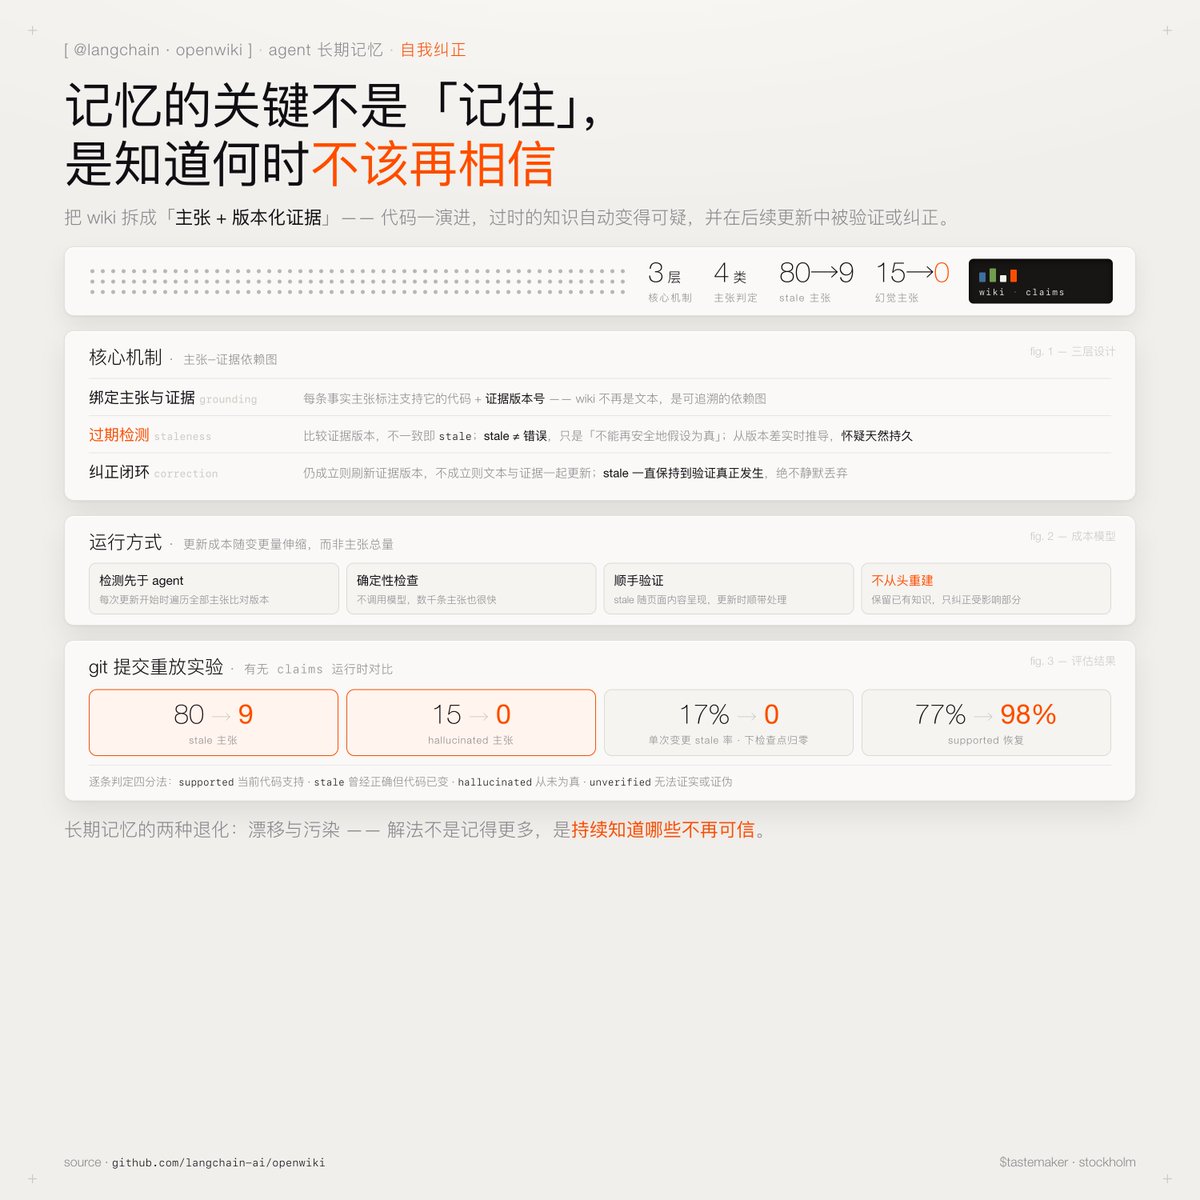
LangChain旗下的OpenWiki项目开发了一套自纠错记忆系统,解决了源代码变更时知识过时的问题。该系统将维基内容组织为与代码版本化证据绑定的声明。其三层设计包括:基础层(每个事实声明都链接到带有版本追踪的支撑代码)、过时检测层(将存储的证据版本与当前版本对比,标记可能过时的声明)以及纠错循环层(对过时声明重新验证,进行刷新或修正)。过时检测无需模型调用即可确定性运行,即使面对数千条声明也能快速完成。纠错循环集成到常规维基更新中——智能体在阅读页面时遇到过时声明,并将其作为日常工作的一部分处理,从而形成一种随代码变更而非声明总量扩展的成本模型。评估中,该系统将过时声明从80条减少至9条,并消除了所有幻觉声明(从15条降至0条)。
Key insights
长期记忆需要知道何时遗忘
记忆系统的关键能力不仅在于存储信息,更在于识别信息何时不再可信。当前关于智能体记忆的讨论侧重于创建和检索,却忽视了源事实变化导致的记忆漂移和污染问题。OpenWiki通过让不确定性持续存在来解决这一问题——过时声明在被验证前始终保持标记状态,而非被静默丢弃。
确定性过时检测实现可扩展验证
过时检测机制通过比较存储的证据版本与当前版本,无需调用任何模型,因此快速且确定。过时状态是实时推导而非作为状态存储,这意味着不确定性会自然持续直到验证发生。这种设计确保即使面对数千条声明,系统也能快速识别需要重新检查的知识。
纠错成本随代码变更而非知识量扩展
该系统优雅的成本模型意味着智能体仅需处理受实际代码变更影响的声明。过时声明在常规更新中与页面内容一同呈现,智能体将其作为日常工作流程的一部分进行重新验证。这避免了从头重新生成整个维基的高昂代价,而是将精力精确集中在需要的地方。