
Qwen-Image-2.1 开源图像模型及本地部署方案
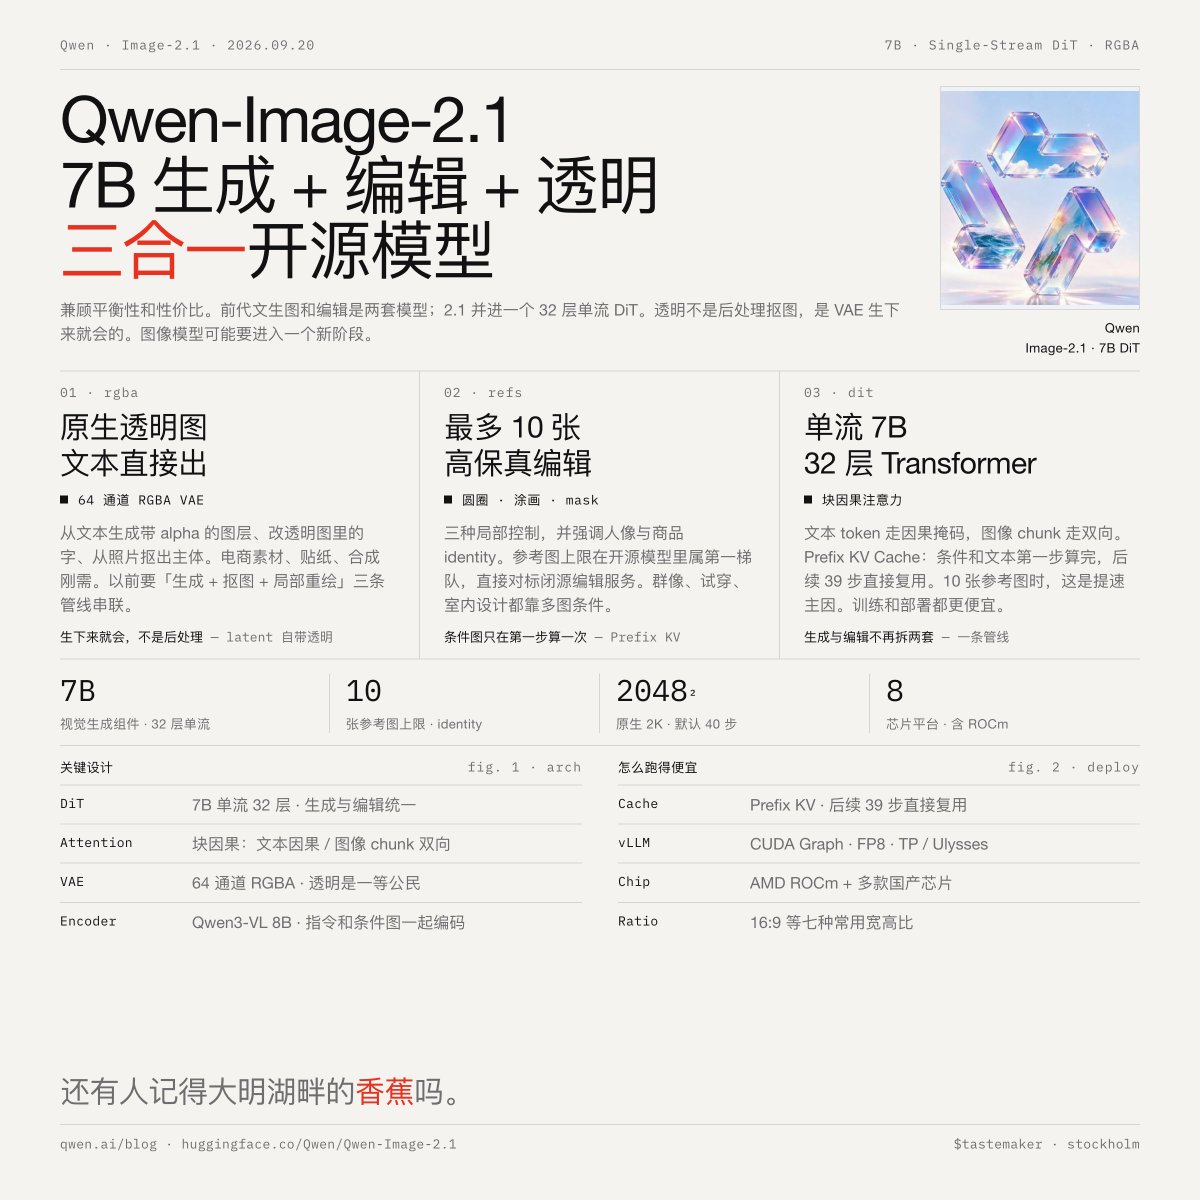
阿里巴巴发布了Qwen-Image-2.1,这是一款开源70亿参数的DiT模型,统一了文生图、图像编辑和透明图像输出功能。它支持多达10张参考图像进行编辑、原生RGBA输出以及2K分辨率。该模型针对vLLM进行了部署优化,兼容8种芯片平台,并可通过Unsloth GGUF量化实现低至12GB显存的本地部署。
Key insights
统一架构与能力
Qwen-Image-2.1采用32层单流DiT,取代了之前独立的生成与编辑模型。它具备块因果注意力机制:文本token使用因果掩码,图像块使用双向掩码。该模型原生生成RGBA图像,其64通道VAE在潜在空间中承载alpha通道,无需单独的抠图流程。
多参考图像编辑
该模型支持多达10张参考图像以实现高保真编辑,提供三种局部控制方法:圆形标注、涂鸦标记和独立遮罩。其重点在于保持肖像和产品身份。前缀KV缓存机制使条件图像和文本可在首个去噪步骤中一次性计算,并重复用于剩余的39个步骤,从而显著加速多图像编辑。
文本渲染与质量改进
Qwen-Image-2.1在文本渲染、人像光线和逼真纹理方面有质的提升。中文文本渲染是继承自Qwen-Image系列的特别优势。该模型使用Qwen3-VL 8B作为文本编码器,统一了文本指令和条件图像的编码,改善了复杂指令的跟随能力。
部署与硬件支持
该模型支持vLLM部署选项,包括CUDA图、FP8量化以及TP/Ulysses并行。它兼容8种芯片平台,包括AMD ROCm和多种国产芯片。默认推理使用40步,原生2K分辨率(2048²),并支持包括16:9在内的七种常见宽高比。
通过Unsloth量化实现本地部署
UnslothAI发布了Qwen-Image-2.1的GGUF量化版本,使其能在消费级GPU上本地部署。对于12-16GB显存(如RTX 4070),Q4_K_M量化可在1024x1024分辨率下运行。对于6GB显存,动态FP8配合卸载提供更高精度但速度较慢。在24GB显存下,INT8实现最佳质量(LPIPS 0.064 vs FP8的0.112)。CPU和Apple Silicon在12-16GB内存下同样支持。
与前代模型对比
Qwen-Image-2.1将之前独立的Qwen-Image(生成)和Qwen-Image-Edit(编辑)模型统一为一个70亿参数的DiT模型。这降低了训练和部署成本。原生的透明图像能力是与需要后处理抠图的竞争对手的根本区别。该模型支持多达10张参考图像的能力在开源模型中位居前列,直接与GPT-Image等闭源编辑服务竞争。