
Raw-RAG在长期对话基准测试中优于智能体记忆
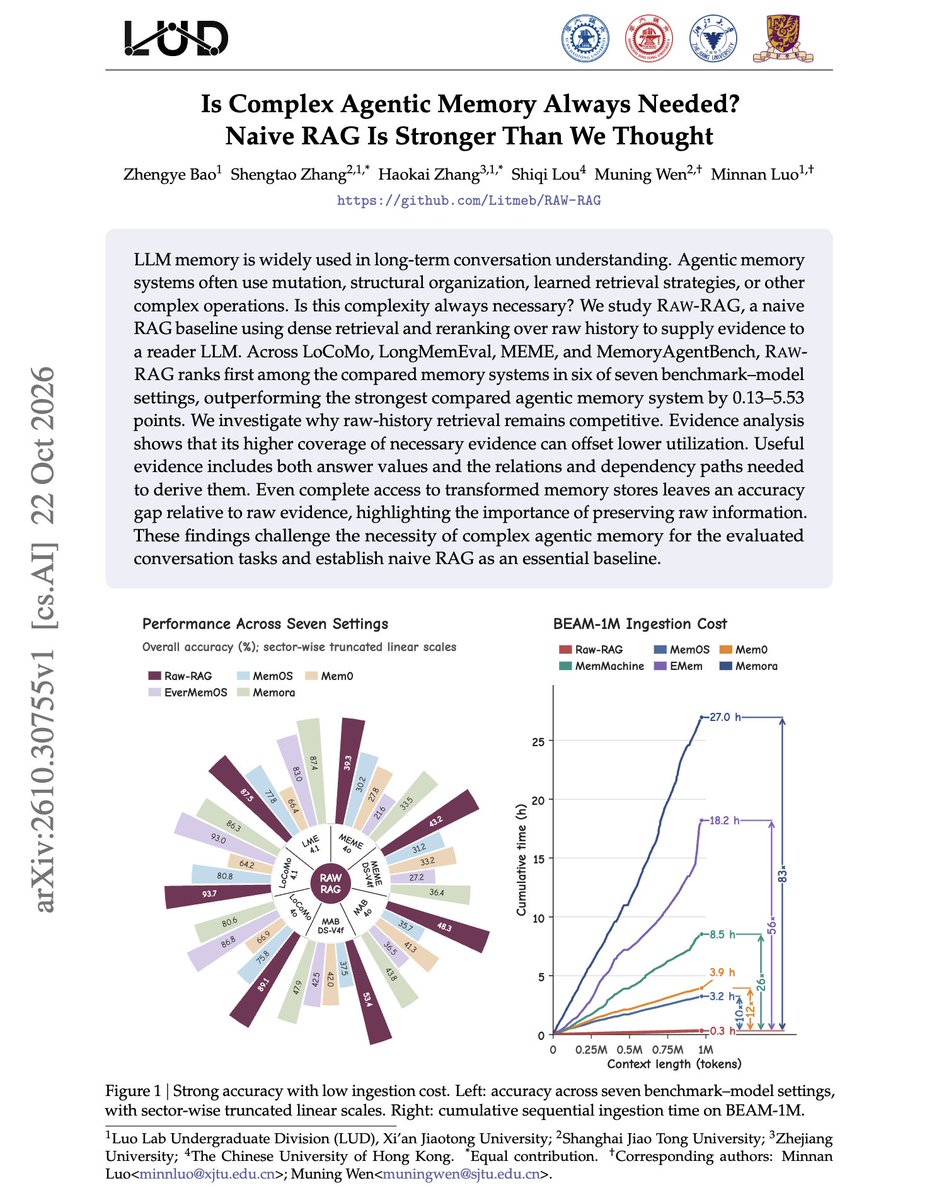
Zhengye Bao及其合著者的一项研究发现,Raw-RAG——一种在原始对话历史上使用稠密检索和重排序的朴素检索基线——在LoCoMo、LongMemEval、MEME和MemoryAgentBench的七个基准模型设置中排名第一,其中六个设置胜出。它比最强的智能体记忆系统高出0.13至5.53分,BEAM-1M的摄入耗时为0.3小时,而所比较的记忆系统为3.2至27.0小时。
事件版本 1.
Key insights
Raw-RAG在多数基准设置中领先
在LoCoMo、LongMemEval、MEME和MemoryAgentBench的七个基准模型设置中,Raw-RAG在六个设置里于所比较的记忆系统中排名第一。它比最强的所比较智能体记忆系统高出0.13至5.53分。
摄入成本远低
在BEAM-1M摄入上,Raw-RAG耗时0.3小时,而MemMachine、MemOS、EMem、Mem0和Memora为3.2至27.0小时。作者称这大约便宜10倍至83倍。
证据覆盖解释结果
原始历史覆盖了问题所需更多证据,包括答案背后的关系和依赖路径,这抵消了较低的利用率。转换为记忆条目往往会丢失这些元素。
Oracle测试偏向原始证据
即使完全访问转换后的记忆存储,相对于原始证据仍存在准确率差距。作者指出,保留原始信息比在其上构建的结构更重要。
消融实验未超越默认
移除重排序使性能下降3.92分,仅返回一个段落使其下降11.73分。添加原子事实提取、摘要增强或图扩展均未超过Raw-RAG默认得分48.32。