RL-XAR利用专家对齐的评分标准击败AI劣质写作
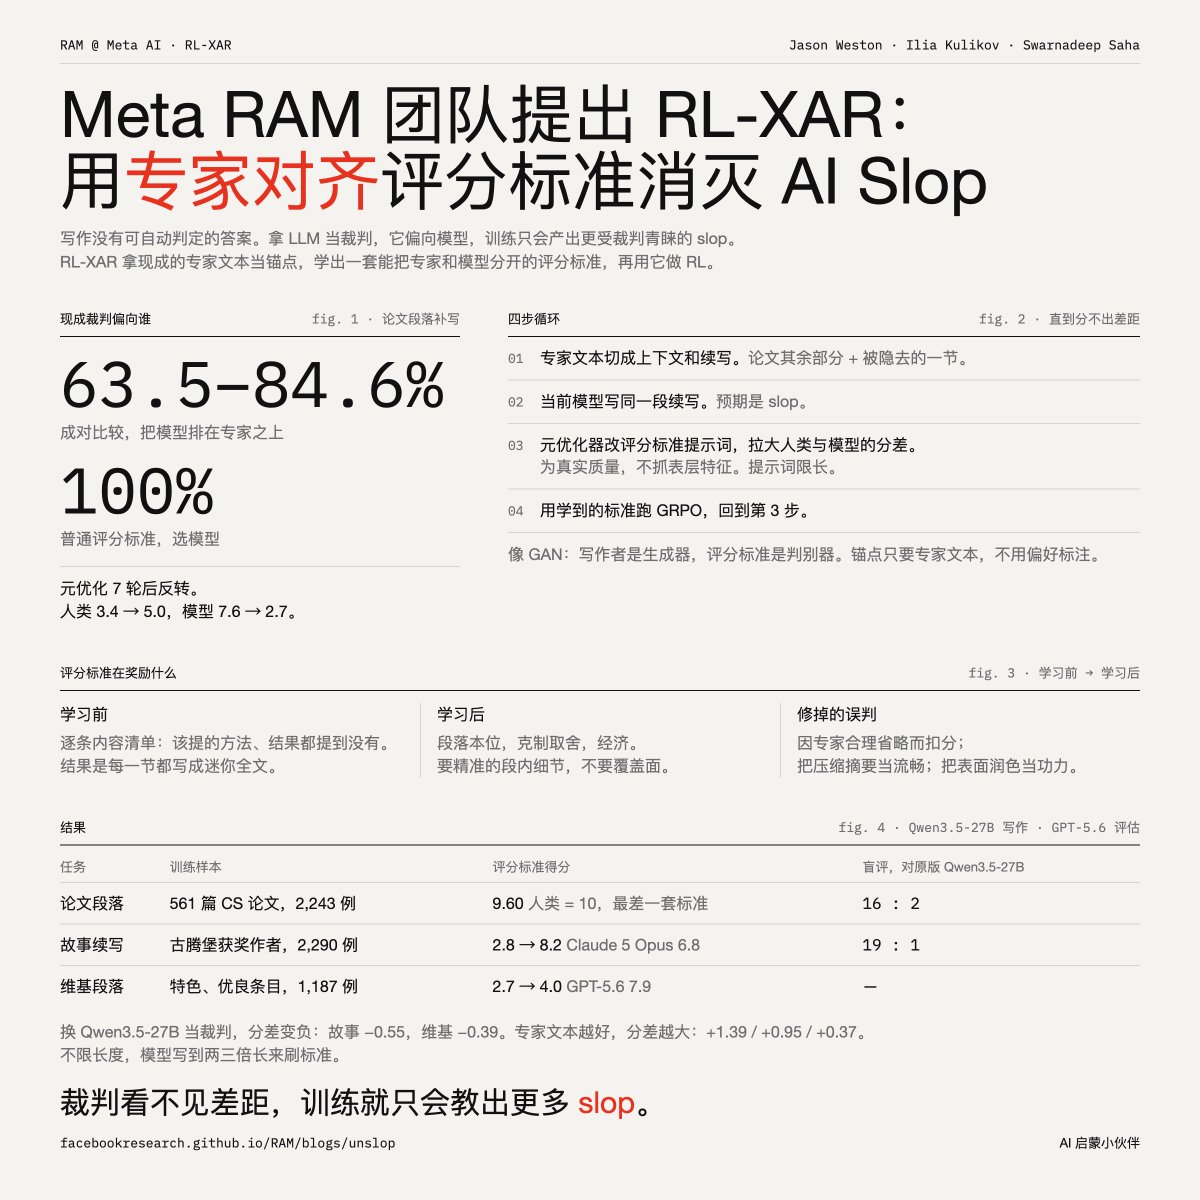
Meta RAM团队的RL-XAR方法以专家文本为锚点,优化区分人类与AI写作的评分标准,并将这些评分标准作为强化学习的奖励信号。在Qwen3.5-27B模型上,该方法在盲评中对抗人类专家时取得了89-95%的胜率。该方法将写作视为写作者与评分标准生成器之间的对抗性博弈。

Meta RAM团队的RL-XAR方法以专家文本为锚点,优化区分人类与AI写作的评分标准,并将这些评分标准作为强化学习的奖励信号。在Qwen3.5-27B模型上,该方法在盲评中对抗人类专家时取得了89-95%的胜率。该方法将写作视为写作者与评分标准生成器之间的对抗性博弈。