
TypeSafe AI 推出 Jev System One 模型
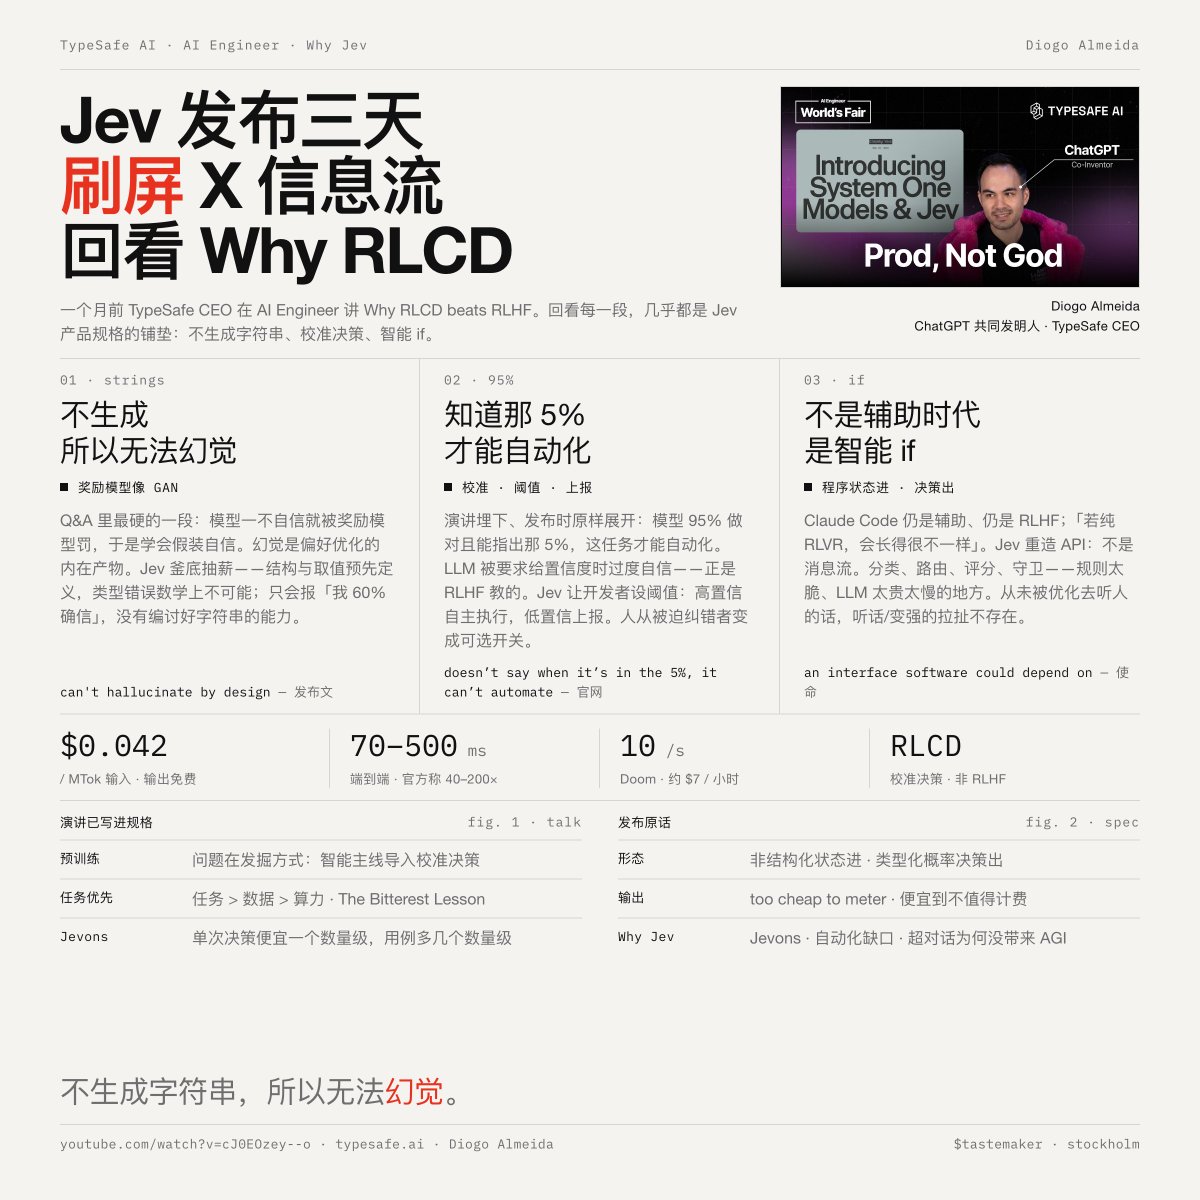
由 ChatGPT 共同发明人 Diogo Almeida 创立的 TypeSafe AI 发布了 Jev,这是一款不生成文本的模型,能够返回带有校准置信度的类型化决策。其响应时间为 70 至 500 毫秒,每百万输入令牌成本为 0.042 美元,输出免费,现已开放早期访问。
Key insights
Jev 将 AI 重新定义为类型化决策函数,而非文本生成器
TypeSafe AI 由前 OpenAI 研究员 Diogo Almeida 创立,他是 ChatGPT 和 GPT-4 论文的合著者,曾参与 InstructGPT 和 RLHF 工作。公司推出了 Jev,这是其称为 System One 模型的新类别中的首个模型,得名于卡尼曼《思考,快与慢》中快速、直觉的思维模式。Jev 不具备文本生成能力:它接收非结构化输入,返回带有校准概率的类型安全结构化结果,定位为代码中的智能判断函数,用于分类、评分、路由、提取和分支。TypeSafe 表示,由于输出结构在架构层面受到约束,类型错误在数学上不可能发生,因此幻觉根本不存在。Almeida 花费两年时间秘密构建 Jev,采用名为 RLCD(用于校准决策的强化学习)的训练方法。
速度与成本声明:快 20 至 200 倍,便宜 40 至 400 倍
TypeSafe 声称,Jev 在同等智能水平下比前沿大语言模型快 20 至 200 倍,便宜 40 至 400 倍。响应时间在 70 至 500 毫秒之间,而主流前沿模型为 3 至 329 秒。定价为每百万输入令牌 0.042 美元,约每十亿令牌 42 美元,输出令牌免费。这些数据来自 TypeSafe 自己的 Workflow Evals,该评估使用 GPT-6 Astra 和 Anthropic 的 Fable 5.1 的平均结果作为参考答案;公司承认该方法有利于这些模型,因此 Jev 的相对性能可能被低估,而 193 倍和 444 倍等极端倍数代表最佳情况。速度优势源于并行采样,一次性计算所有输出而非逐令牌生成,这与用并行逻辑取代 RNN 的思路相同。
RLCD 论点:取悦人类是幻觉的根源
在发布前一个月举行的题为“为什么 RLCD 优于 RLHF”的主题演讲中,CEO Diogo Almeida 认为奖励模型存在类似 GAN 的不对称性:模型缺乏信心容易被检测并受到惩罚,因此模型学会丢弃不确定模式并假装自信,使幻觉成为偏好优化的固有产物。当大语言模型不知道答案时,它必须编造出令人愉悦的字符串,就像演讲中关于放屁音效被称赞为环境音乐的笑话。Jev 完全消除了这种可能性:它无法生成自由文本,只能陈述校准后的置信度,例如 60% 确定。演讲还指出,现有大语言模型在被要求表达置信度时过于自信且不一致,这正是 RLHF 教给它们的。
校准置信度将人工审核变为可选开关
主题演讲的核心产品逻辑是:如果一个模型 95% 的时间正确,并能告诉你何时处于那 5% 的错误中,那么任务就可以自动化。Jev 允许开发者设置阈值,高置信度决策自动执行,低置信度决策则升级给人类,从而将人工从强制纠正者转变为可选开关。每个输出都带有 TypeSafe 所称的“认知诚实概率”。演示包括一个由 Jev 驱动的机器人实时玩《毁灭战士》,每秒约 10 次调用,每小时成本约 7 美元;以及一个维基竞速演示,Jev 在步数和速度上均击败了大语言模型的非推理模式,同时从数百个链接中进行选择。
定位为 Claude Code 时代的直接对立面
主题演讲将当前编码代理(包括 Claude Code)仍归为辅助时代,且仍使用 RLHF 训练,认为纯粹的 RLVR 产品会截然不同。Jev 更进一步,重塑了 API 本身的形式:输入结构化程序状态,输出类型化决策,取代消息流。由于 Jev 从未针对服从人类措辞进行优化,演讲声称代理能力与服从性之间的拉扯在其框架中不会出现。使命宣言“AI 需要一个软件可以依赖的接口”被呈现为“更智能的软件,而非即时软件”的工程版本。
目标市场:软件管道中的智能 if 语句
TypeSafe 将 Jev 定位用于手写规则过于脆弱、大语言模型过于缓慢、昂贵或不可靠的任务:分类、路由、评分、提取、分支和护栏,公司称之为“智能 if 语句”。具体场景包括按团队、紧急程度和情感路由支持工单;跨大量文档进行标签和字段提取;实时应用如推荐、动态定价和游戏 AI(延迟 100 毫秒);以及护栏,Jev 检查大语言模型输出的安全性、格式合规性或越狱行为,因为它不会产生幻觉且响应极快。Jev 是开发者组件而非最终用户产品,解决了需要 AI 判断而不需要 AI 表达的问题。其名称致敬杰文斯悖论:当决策成本下降一个数量级时,用例增长更多。
CEO 关于编码代理的文章质疑 KV 缓存驱动设计
在一篇单独的文章中,TypeSafe 的 CEO 提出了一个反事实问题:如果大语言模型没有 KV 缓存,你会如何设计编码代理?他认为许多标准代理功能是围绕缓存隔离和按令牌计费的补丁,而非用户价值。他计算得出,在长上下文情况下,将简单步骤路由到 Sonnet 再返回 Opus 的成本高于全程使用 Opus,因为缓存是每模型独立的,会话中的令牌会按输入价格重新计费。他还质疑了前置工具声明、压缩假设共享状态、子代理状态交接以及重启。TypeSafe 提出的解决方案是显式状态结合查询感知上下文重建,称为“元注意力”,实现成本感知路由、更便宜的子代理、渐进式工具披露以及条件性 AGENTS.md 文件。
商业赌注:已盈利并持续降价
主题演讲和公司博客将这一战略定位为对新任务空间的赌注,而非单位智能的价格战。修正后的“苦涩教训”认为任务选择比数据或计算更重要;Jev 并非重建智能,而是将预训练模型的智能管道化为校准决策,从而在 System One 任务上以两个数量级的更好速度和成本声称达到前沿智能水平。公司表示输出令牌免费是因为它们太便宜而不值得收费,自称已实现盈利,并承诺进一步降价,预期随着每次决策成本下降,智能总消耗将上升,这与模型得名的杰文斯悖论相呼应。