
Viggle发布JST-2 3D原生世界模型,采用物理原生Token
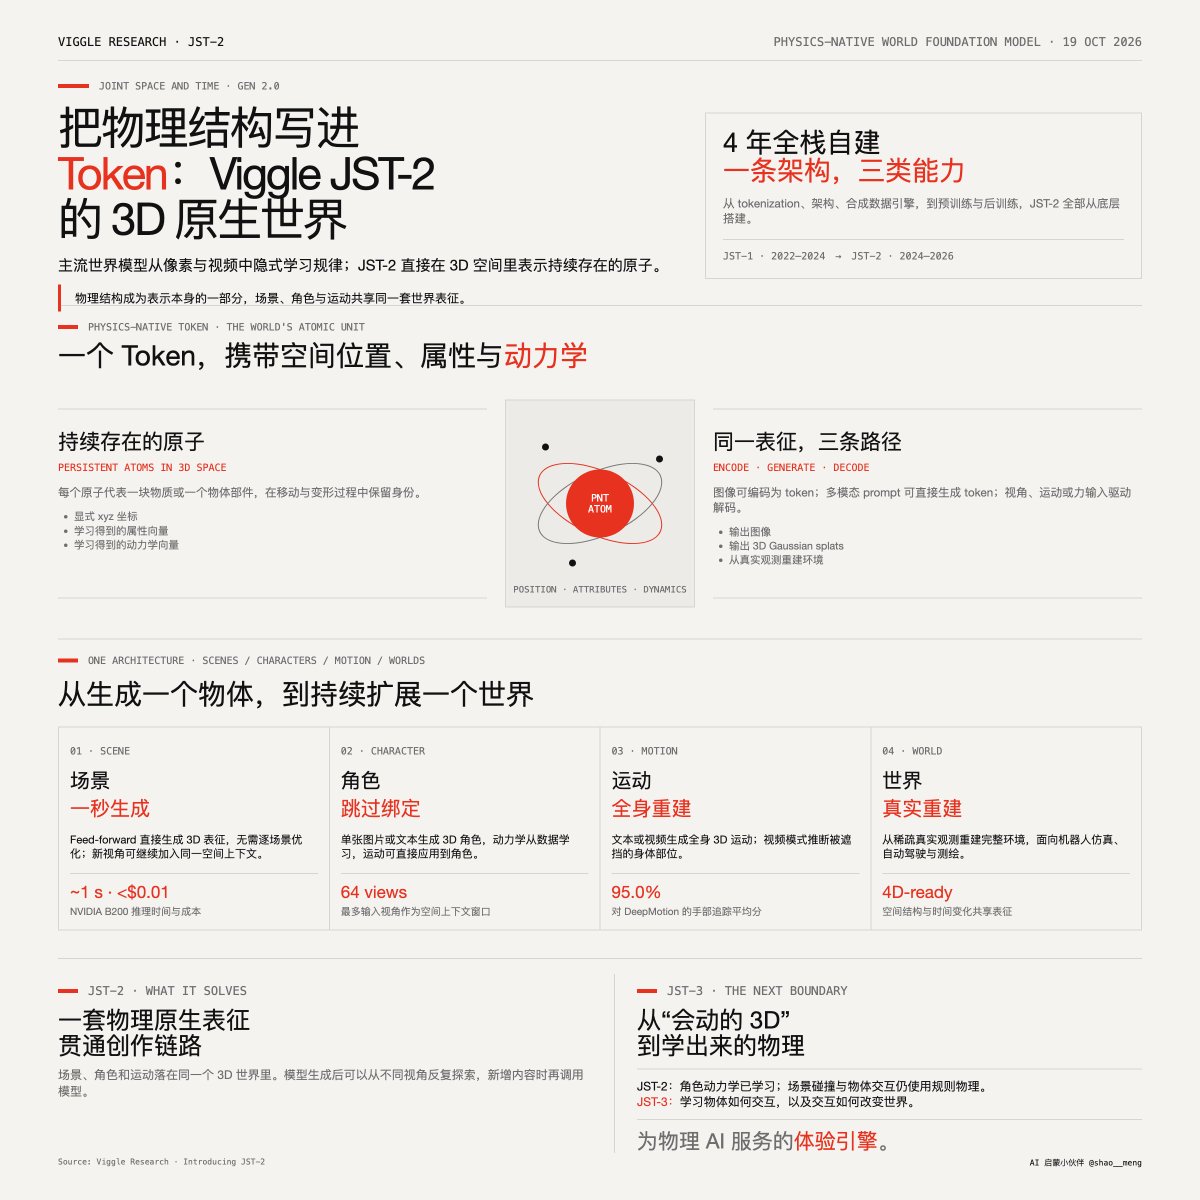
Viggle发布了JST-2,这是一个完全在3D空间中构建的世界模型,使用携带显式xyz坐标、学习到的属性向量和学习到的动态向量的物理原生Token。该模型在B200上以每场景低于0.01美元的成本在约一秒内生成完整3D场景,无需绑定或蒙皮即可从单张图像或文本生成3D角色,并能从文本或视频生成全身运动。Viggle报告称在盲测人类偏好中优于Meshy、Tripo、Cartwheel和DeepMotion,并概述了JST-3将把学习到的动态扩展到物体交互。
事件版本 1.
Key insights
物理嵌入表示
JST-2将世界建模为持久3D原子,每个原子携带显式xyz坐标、学习到的属性向量和学习到的动态向量。物理结构是表示的一部分,而非从像素外观推断。
三组件架构
JST编码器将图像转换为物理原生Token,JST生成器直接从多模态提示生成Token,JST解码器结合视点和运动或力输入,输出图像或3D高斯泼溅。
四年自建全栈
Viggle内部构建了Token化、架构、数据合成引擎、预训练和后训练,JST-1跨越2022–2024年,JST-2跨越2024–2026年。需要合成数据,因为3D原生训练数据在自然界几乎不存在。
统一生成能力
JST-2在B200上以低于0.01美元的成本每次前向传播约一秒生成完整3D场景,支持多达64个输入视图作为空间上下文窗口,无需绑定和蒙皮即可从单张图像或文本生成3D角色,并从稀疏真实观测重建完整3D环境。
盲测偏好结果与JST-3路线图
在盲测人类偏好测试中,JST-2在角色生成方面对Meshy 7.1胜率58.4%,对Tripo H3.1胜率73.2%;在视频驱动运动方面对Cartwheel胜率58.1%,对DeepMotion胜率89.1%,手部跟踪达95%。JST-3旨在将学习到的动态扩展到物体交互,取代基于规则的模拟。