
上下文工程与人工智能代理
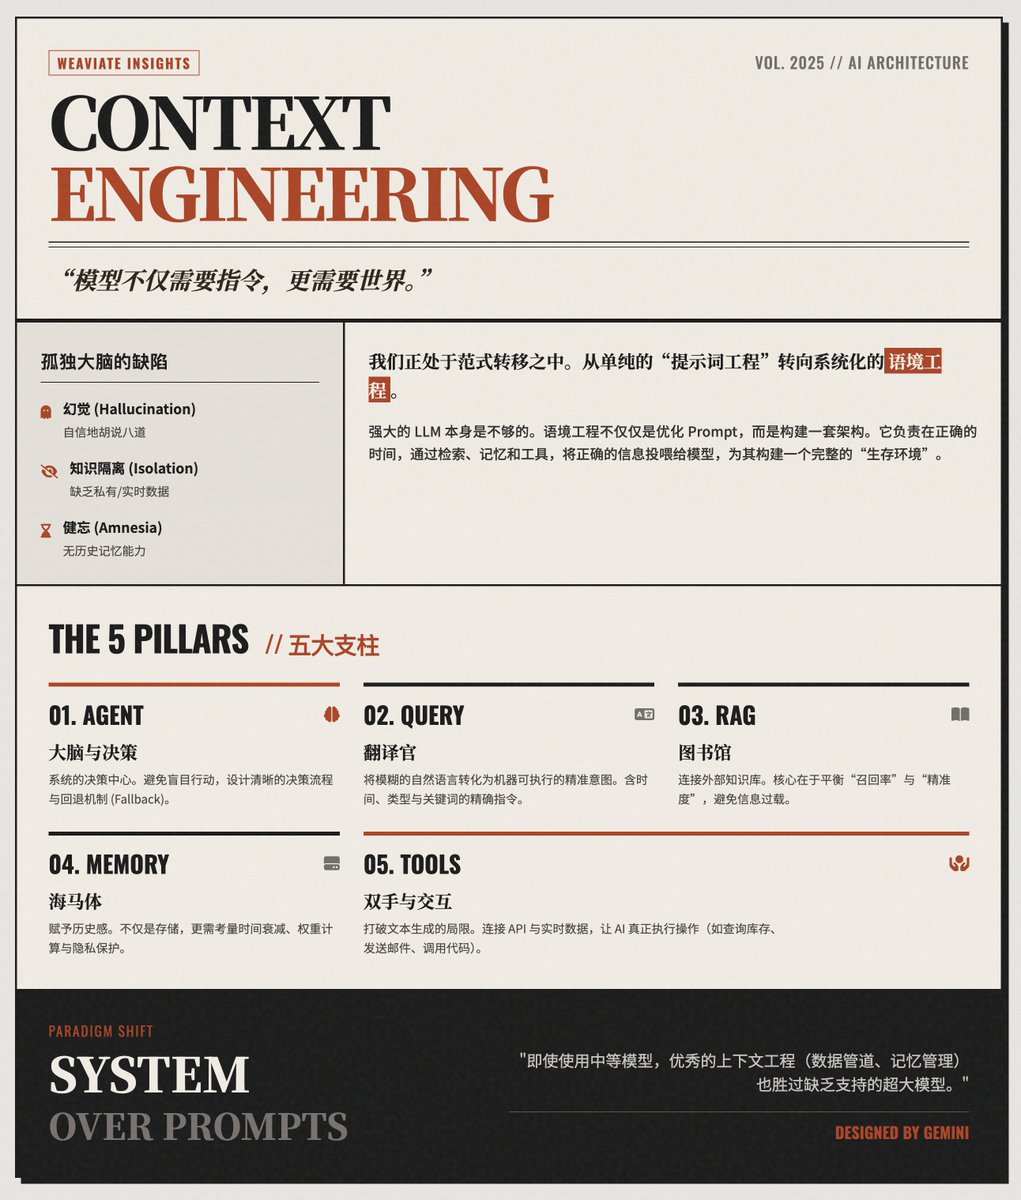
上下文工程重新构架了代理设计。
Key insights
大型语言模型并非自给自足;需要上下文
大型语言模型存在三个核心缺陷,多个帖子中提到:幻觉、知识孤立(缺乏私人或最新数据)和缺乏持久记忆(帖子17374,17331)。上下文工程被提出作为架构响应:它不仅仅是优化提示,而是构建一个运行时环境——包括记忆存储、检索层和工具接口——在推理过程中为模型提供及时、相关的信息。论点指出,即使是功能强大的大型语言模型,除非连接到面向世界的数据和持久机制,否则也表现得像一个孤立的“脑”(17374,17331)。
五大支柱定义生产上下文工程
提出了一个具体的五大支柱蓝图用于生产AI:代理(决策中心)、查询增强(意图翻译器)、检索(知识库)、记忆(具有衰减和隐私的历史上下文)和工具(API和操作)(帖子17374)。每个支柱都有操作建议:代理需要明确的决策流程和后备机制;查询增强必须将模糊的用户查询转换为精确的检索指令;检索系统必须调整召回与精度的平衡;记忆需要权重和过期政策;工具必须作为可调用接口暴露,以便实现现实世界的操作(17374)。
从提示工程到系统设计的范式转变
材料反复强调了一种方法论的转变:之前对提示措辞的重视被系统级上下文工程所取代(帖子17338,17374)。指导包括“编码前规划”(规范驱动开发)、将相关代码/文档动态组装到模型上下文中,而不是静态粘贴,以及基于角色或约束的提示以获得更安全的输出。声称设计良好的上下文管道可以使中等规模的模型超越缺乏上下文设计的大型模型(17338,17374)。
防止上下文噪声的工程模式
防止上下文噪声的工程模式包括:工具搜索(动态加载工具定义,而不是将所有工具嵌入系统提示中)、程序化工具调用(私下执行代码,仅暴露总结结果),以及通过代码执行将大型原始输入与模型隔离,以避免令牌污染(帖子17331)。这些做法以计算换取更清晰的上下文,并保持模型对重要信息的关注(17331)。
长时间任务的代理架构使用锚点
推荐使用两个代理来处理长时间任务:初始化代理创建全局规划文档(例如,feature_list.json,progress.txt),后续编码代理仅读取这些锚点,而不是长聊天记录(17331)。推荐外部存储(文件、Git提交)作为持久记忆介质;强制代理提交更改(git commit)提供可靠、可查询的项目记忆(17331)。
开发者工作流:规范驱动、测试优先、多代理编排
推荐的AI辅助开发软件工程实践包括在编码前创建迷你PRD/规范,要求AI提出计划,让AI在编码前编写测试(红-绿-重构),以及运行带有沙箱和回滚点的多代理管道(帖子17338)。命令行驻留代理和编排的代理角色(规划者、编码者、测试者、文档编写者)被描述为未来的开发环境(17338)。
工具:确定性输出、反压和噪声过滤
操作工具的建议包括默认生成简洁确定性输出的包装器(例如,成功时的单个勾选),仅在失败时暴露完整日志,使用快速失败/测试退出选项逐个处理错误,并过滤日志以仅保留失败断言行(帖子17373)。这些措施减少了令牌浪费,防止上下文窗口溢出,并保持模型在其最佳令牌“智能区”内(17373)。