
人工智能代理的上下文工程
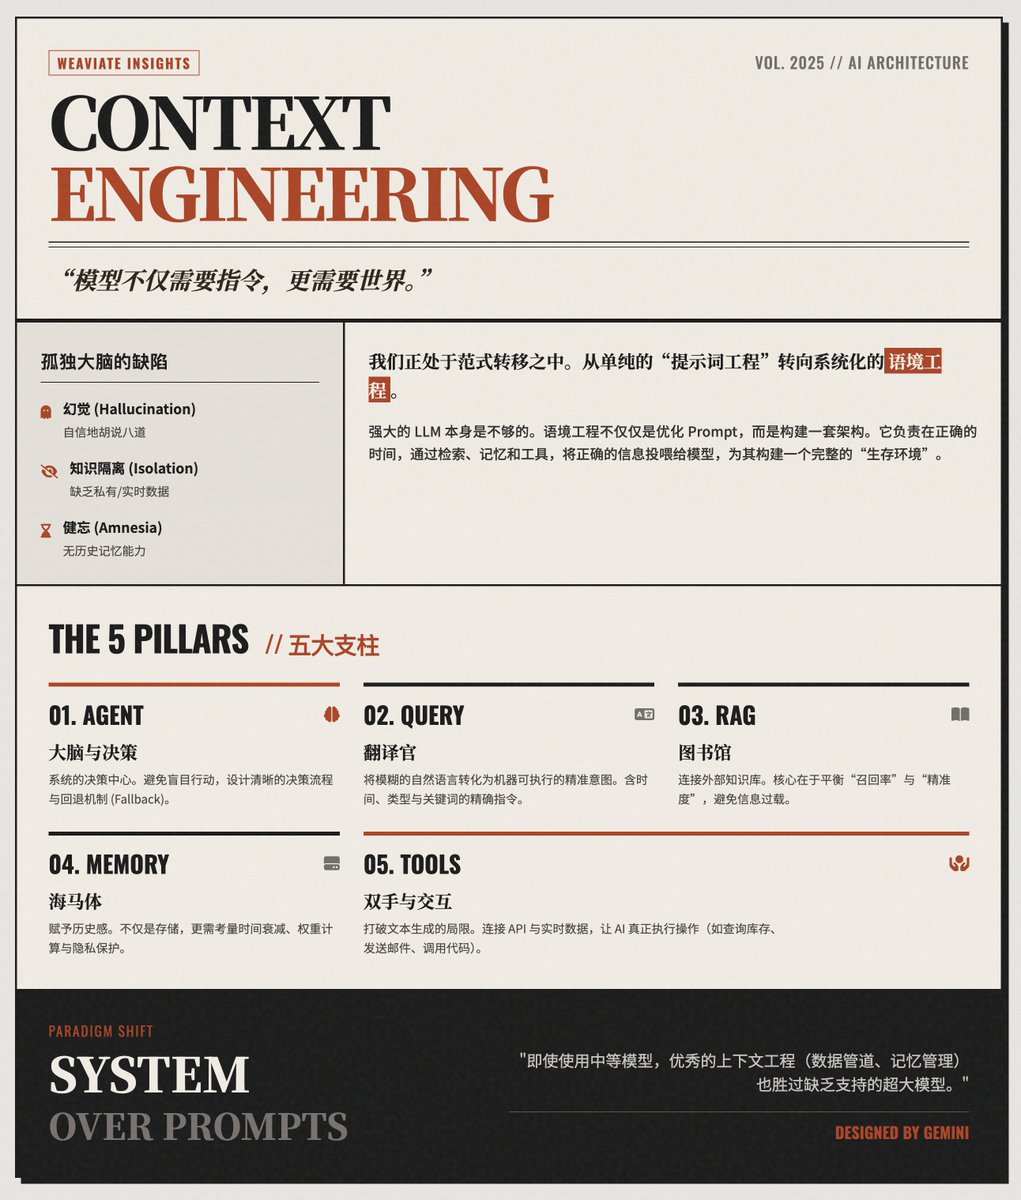
上下文工程解决了模型盲点,并将大型语言模型(LLMs)与现实世界连接起来。
Key insights
上下文工程是连接大型语言模型与现实世界的必要条件
上下文工程被视为解决大型语言模型三大固有缺陷的系统级解决方案:幻觉、知识孤立(缺乏私有或实时数据)以及缺乏持久记忆。这一方法强调在决策时为模型提供正确的外部信息,而不是仅仅依赖于更大的模型容量。它将工程化的上下文——包括检索、记忆和工具——视为必要的基础设施,使模型能够在更丰富的外部环境中进行推理,而不是作为一个独立的“脑”。
五大架构支柱定义了生产上下文工程
文章列举了生产AI应用的五个核心模式:代理(具有明确流程和回退机制的决策中心);查询增强(将模糊的自然语言转换为精确的检索/执行意图,例如,添加时间/类型/关键词);检索(在召回和精度之间进行权衡以连接知识库);记忆(具有时间衰减、重要性加权和隐私控制的历史上下文);以及工具(API和操作,使代理能够执行超出文本生成的操作)。每个支柱都有具体的责任和约束。
工程化上下文优于原始模型规模以提升系统性能
文章对比了旧的提示工程方法与现代上下文工程:投资于数据管道、检索质量和记忆管理通常能带来比单纯使用更大模型更好的系统结果。建议设计端到端的上下文交付,使得即使是中型模型也能超越缺乏上下文集成的超大模型。这一思路将努力从提示措辞转向架构(数据流、检索器、记忆策略、工具集成)。
反压和确定性过滤减少编码代理中的令牌浪费
另一项分析建议使用工具级的确定性控制,以减少来自冗长工具输出(例如,测试日志)的令牌浪费。这一模式是一个包装器,默认吞噬输出,在测试通过时发出简洁的成功标记(✓及标签),并仅在失败时转发完整日志。其他策略包括快速失败标志(在第一次失败时停止)、仅提取失败的断言、剥离堆栈跟踪/时间戳,以及避免盲目截断,这可能会强制重新运行。该指导强调工具链噪声的减少,而不是依赖模型启发式来忽略无关的令牌。