
人工智能编码代理的进展与基准
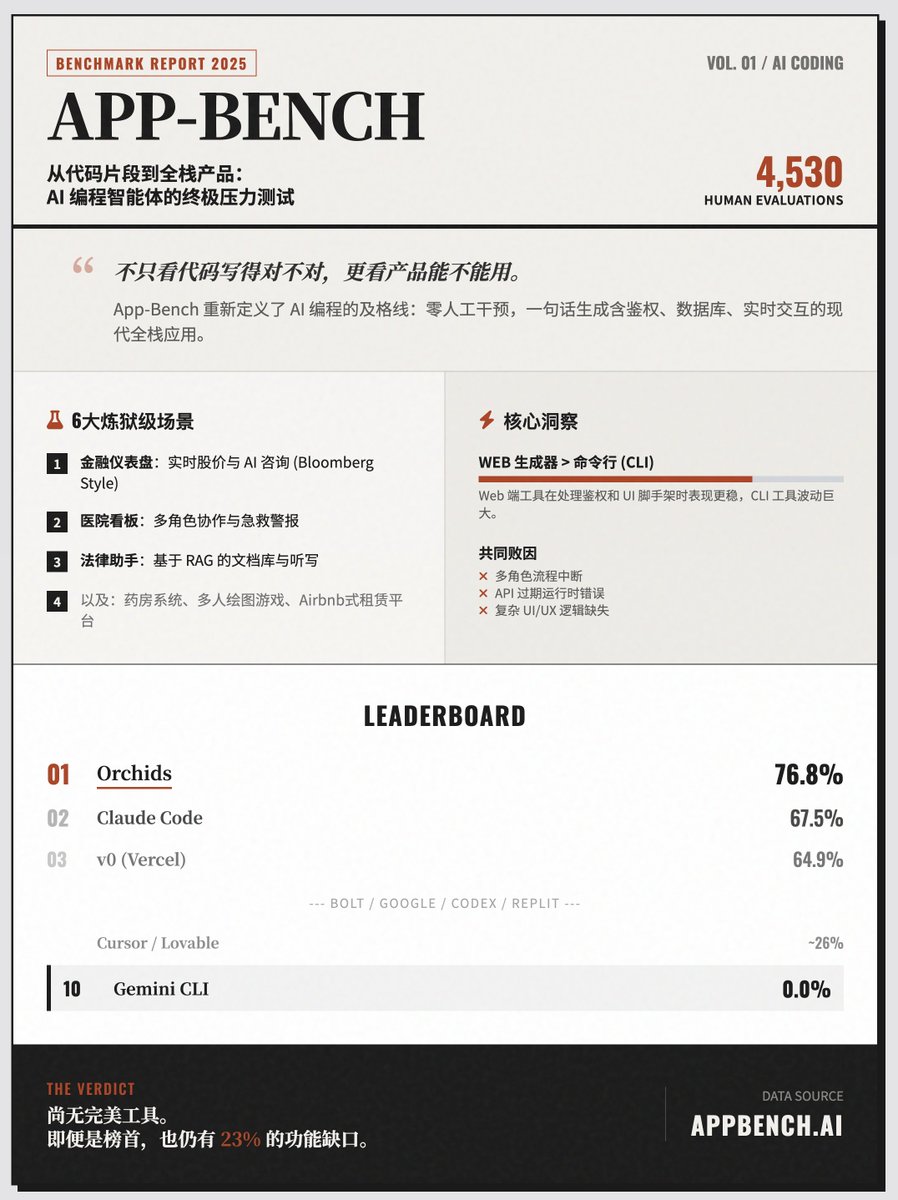
基准测试和进化编码代理测试端到端开发者自动化。- App-Bench 评估零人工全栈应用生成 - 六种场景:金融仪表板、医院管理板、法律助手、药房、猜词游戏、租赁平台 - 评分:151个标准,4530次人工评估,每个工具三次尝试 - 排名最高:Orchids 76.8%,Claude Code 67.5%,v0 64.9%,Gemini CLI 0.0% - 最佳工具仍覆盖约77%的所需功能 - 主要失败:多角色流程、API过期、UI/UX和缺失功能 - 网络生成器在稳定性和认证/UI方面优于CLI - AlphaEvolve = Gemini + Evolution;谷歌宣布私人测试版 - AlphaEvolve运行进化搜索:问题规格 + 评估者 + 种子程序 - 内部收益:约0.7%的数据中心计算恢复,内核速度提升23%,整体训练时间下降1% - AlphaEvolve作为服务API提供编码优化。
Key insights
App-Bench评估零人工全栈应用生成
App-Bench是一个高难度基准,测试AI代理是否能够从单一自然语言提示生成一个完整、可用的现代Web应用,而无需人工干预。它使用六种复杂的现实场景(金融仪表板、医院管理板、法律助手、药房系统、多人猜词游戏和租赁平台)。评分依赖于高级全栈开发人员在151个标准下的人工评估,总计4530次评估;每个工具有三次尝试,记录最佳得分。
基准结果显示能力差距和排名细节
App-Bench的结果显示,Orchids以76.8%排名第一,Claude Code以67.5%排名第二,v0(Vercel)以64.9%排名第三,Gemini CLI得分为0.0%。即使是排名最高的工具也仅达到约77%的所需功能。常见的失败模式包括缺失多角色工作流、过期或损坏的API导致运行时错误,以及影响可用性的UI/UX问题。基于Web的生成器在平均性能上略优于CLI工具,而CLI工具在处理认证和基础UI逻辑时表现出更高的方差。
AlphaEvolve将算法设计转变为进化搜索
AlphaEvolve被描述为Gemini + Evolution,是一个基于进化的编码代理,接受问题规格、目标评估者和种子程序,然后通过基于Gemini模型和自动评估者的突变和选择来进化代码变体。谷歌宣布AlphaEvolve处于私人测试阶段,并报告了内部收益:在调度中恢复了约0.7%的全球数据中心计算,关键内核速度提升23%以改善训练性能,以及整体训练时间下降1%。该服务通过API对外提供。
基准设计和失败分析强调端到端差距
App-Bench的方法论——复杂场景、人工评分和每个工具的多次尝试——突显了当前编码代理能够编写代码片段,但在满足端到端产品需求方面存在困难:多用户角色、实时同步、认证流程和生产级UI/UX。基准的人工、标准丰富的评分揭示了实施和集成问题是主要短板,而不仅仅是代码的正确性。这表明当前代理需要更强的系统集成、运行时验证和更新处理,以达到生产就绪状态。