
代理检索与记忆:低延迟搜索与长任务的上下文压缩
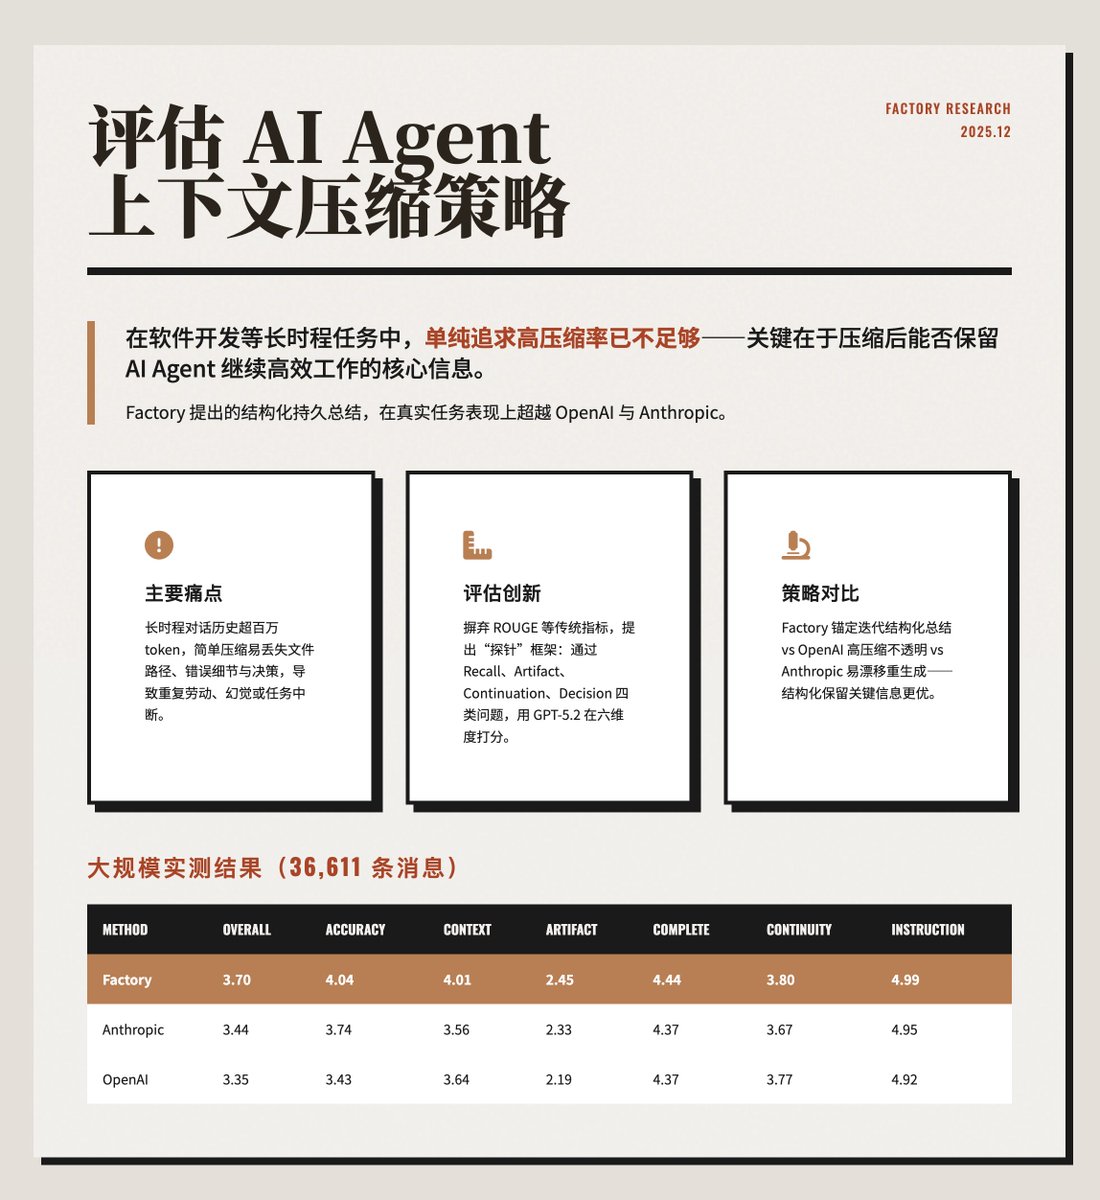
新的评估显示,结构化的锚定摘要和毫秒级检索对于长时间运行的代理任务至关重要。
Key insights
压缩质量必须保留可操作工件,而非最大化比例
对代理上下文压缩的评估发现,极端压缩(高比例)往往会丢弃低熵但可操作的细节,如文件路径、错误追踪和决策工件。FactoryAI的“锚定迭代摘要”保持了结构化的持久摘要(意图、文件更改、决策),并通过保持连续性超越了通用的压缩方法,使代理能够在不重新工作的情况下继续任务。
基于探测的评估更好地衡量代理的压缩效用
研究人员提出了基于探测的评估方法,以测试压缩上下文的召回、工件保留、继续性和决策可追溯性。该框架在压缩后使用针对性的查询来验证任务继续所需的关键元素是否仍然可访问,而不是仅依赖ROUGE或嵌入相似性。
Opennote的Index强调毫秒级检索和混合过滤
Opennote描述了Index:一个基于Postgres(pgvector + pg_trgm + tsvector)和Cloudflare边缘运行时构建的检索系统,能够为多租户个人知识搜索提供P99 < 300ms的响应时间。Index结合了元数据过滤、混合语义+关键词搜索、细粒度缓存、块级失效和最小重嵌入,以满足代理的需求。
生产检索需要全球分布、动态更新和精确重排序
Opennote的管道支持基于全球Workers的摄取、块级哈希以避免重新处理,以及关键词和向量分数的动态混合。该架构支持多租户过滤和即时缓存失效,以保持代理在不断演变的文档上操作的正确性。
代理记忆设计应优化每任务的令牌成本而非原始压缩
作者建议在代理的工作流程中优化端到端令牌消耗,而不是最大化每次调用的压缩百分比;结构化的锚定摘要和工件索引减少了重复检索和生成的成本。
实际索引选择更倾向于关系引擎以实现动态过滤
Opennote选择基于Postgres的组合检索而非仅基于向量的存储,因为关系元数据过滤有效地在嵌入相似性之前减少了候选集,从而改善了延迟和多租户隔离,以便于代理查找。