
基于EXPO-FT的机器人后训练:通用强化学习方法
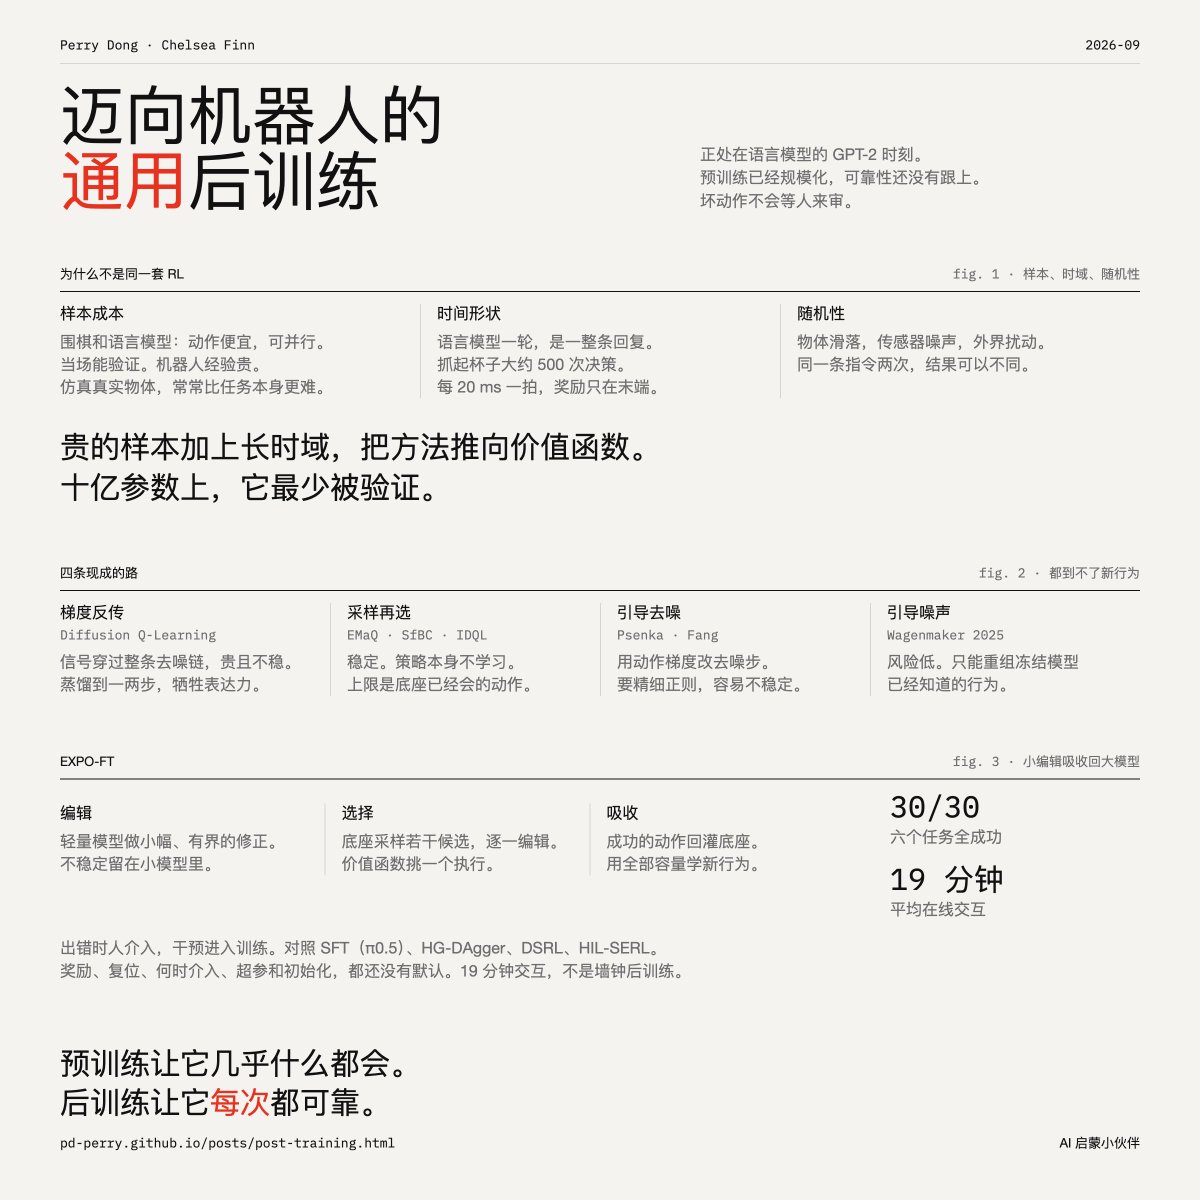
研究人员提出了EXPO-FT,一种基于价值的强化学习方法,用于大型机器人模型的后训练。它利用一个轻量级编辑策略来优化动作,在仅需19分钟在线交互的情况下,在六项复杂任务上实现了30/30的成功率。该方法解决了长时域机器人任务中信用分配的核心挑战。
Key insights
机器人的“GPT-2时刻”与后训练需求
机器人领域正处于“GPT-2时刻”:预训练(VLA、世界-动作模型)已规模化,赋予模型广泛但不可靠的能力。目前缺失的是一个标准化、可复用的后训练流程,将“能做”转变为“每次都能可靠完成”。作者认为,机器人领域需要类似大语言模型中的监督微调、RLHF和RLVR流程,但可靠性要求更为严格,因为机器人领域的一次错误动作无法在发生前进行审查。
机器人强化学习与大语言模型强化学习的关键区别
机器人强化学习与大语言模型强化学习存在三点差异:样本成本(机器人经验昂贵,真实物体的仿真可能比任务本身更难)、时间形态(机器人每个回合涉及数百到数千个低级决策,且仅在最后获得奖励,使得信用分配极其困难)以及随机性(物体滑动、传感器噪声、外部干扰会污染信用分配)。这些因素促使机器人领域转向基于价值的强化学习,而该系列方法在十亿参数规模下是验证最少的。
现有方法为何失败
论文系统评估了现有方法:扩散Q学习存在长去噪链问题;采样后选择方法(EMaQ、SfBC、IDQL)从未学习策略,受限于基础模型的提议;动作梯度引导需要精细的正则化;输入噪声空间引导只能重组已知行为。经典的基于价值强化学习(DDPG/TD3/SAC)假设高斯单峰策略,而前沿模型使用扩散/流生成多模态行为,且自举误差会在十亿参数规模下放大不稳定性。
EXPO-FT机制:小模型编辑与吸收
EXPO-FT采用三阶段设计:(1)编辑策略(轻量级小模型)对基础模型生成的候选动作进行有界修正,将其推向各自模态内的价值峰值;(2)执行时,机器人采样多个候选动作,进行编辑,并通过价值函数选择最优动作;(3)吸收:成功动作被反馈给预训练的大模型,使小编辑策略的改进得以内化。强化学习的不稳定性被限制在小模型内,从而避免大模型产生危险动作。
实验结果与人在回路
EXPO-FT在六项复杂操作任务(例如将电线穿过挂钩并插入、台球入袋、翻蛋)上进行了测试。在平均19分钟的在线交互中实现了30/30的完全成功,显著优于π0.5上的SFT、HG-DAgger、DSRL和HIL-SERL等基线(后者平均成功5.5–20.5次)。人类作为监督者:当机器人出错时,人工干预数据进入训练,类似于Waymo的远程安全操作员。
通用采用面临的开放协议问题
论文指出了社区趋同必须解决的若干问题:如何指定奖励(机器人领域缺乏RLVR的等价物;学习型成功分类器或奖励模型前景广阔)、谁执行重置(学习型重置策略、可逆任务设计)、需要多少人工干预及何时干预、默认超参数(学习率、UTD比率、停止准则、控制频率),以及如何加权初始化数据。作者发布了EXPO-FT的调优参考,作为迈向标准化的一步。