
多份报告分析AI递归自我改进进展
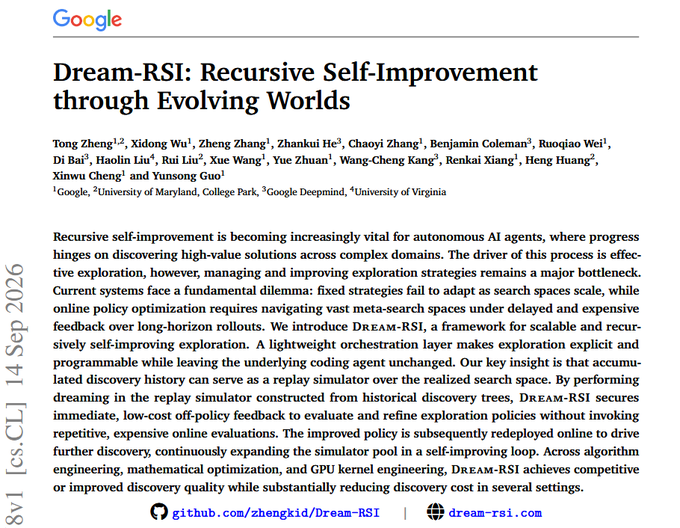
来自Google DeepMind、Databricks、Anthropic和NVIDIA的最新报告审视了AI递归自我改进的现状。Google的Dream-RSI将智能体调用次数减少高达162倍。Databricks CEO认为RSI标准尚未满足,真正的风险是AI驱动的网络攻击。Anthropic的内部仪表盘显示26%的研发任务由AI主导。NVIDIA的Agora系统使13个智能体在12天内协作改进了一个模型。
Key insights
Google DeepMind的Dream-RSI:重放过往发现
Dream-RSI重放过去的发现过程,以低成本测试数千种探索策略,然后将更优策略反馈至下一轮。在算法设计、数学优化和GPU内核工程中,它在保持或提升结果质量的同时,将智能体调用次数减少高达162倍。这展示了一种闭环自我改进机制。
Databricks CEO:RSI标准未满足,真正风险是网络攻击
Ali Ghodsi提出了RSI的四个条件:降低计算成本、缩短时间、提升智能和可重复性。他认为这四个条件目前均未满足:训练成本从约1亿美元升至50-100亿美元,时间更长,且存在失败案例。他将存在风险视为“接近零”,并强调AI驱动的网络攻击才是真正威胁,CVE到武器化的时间已缩短至数小时。
Anthropic内部仪表盘:26%的研发任务由AI主导
Anthropic发布了三项指标:(1)研发自动化指数:26%的研发任务由AI主导(AL4级),90%以上有AI深度参与,无任务达到AL5级。(2)智能体监督:3万个智能体同时运行,100%的操作被在线监控,拦截率为0.002%,每周约50次对话升级至人工审查。(3)计算资源分配:6%的AI研发计算资源用于安全工作。这些为追踪加速情况提供了基线。
NVIDIA的Agora:基于Git共享状态的多智能体协作研究
Agora将研究视为基于Git的有向无环图,其中每个声明都是一个提交。13个编码智能体(Claude Code + Codex)在无中央规划的情况下运行了12天,产生了1703项贡献。它们将模型的bpb从3.392改进至1.899,缩小了与训练后的GPT-2 124M之间62%的差距。获胜方法传递的是行为知识(二元组分布)而非参数,这是一项科学上的新颖发现。
AI自我改进的5级分类法
一份由30多位研究人员撰写的75页论文将AI自我改进分为5个级别,从第1级(人类决定改进内容)到第5级(AI重写流程以创造下一代AI)。在审查的491篇论文中,75%仍处于第1-2级,不到6%达到第5级。这为评估进展提供了一个结构化框架。