
大型语言模型基础设施:检索、记忆、提示迁移与评估
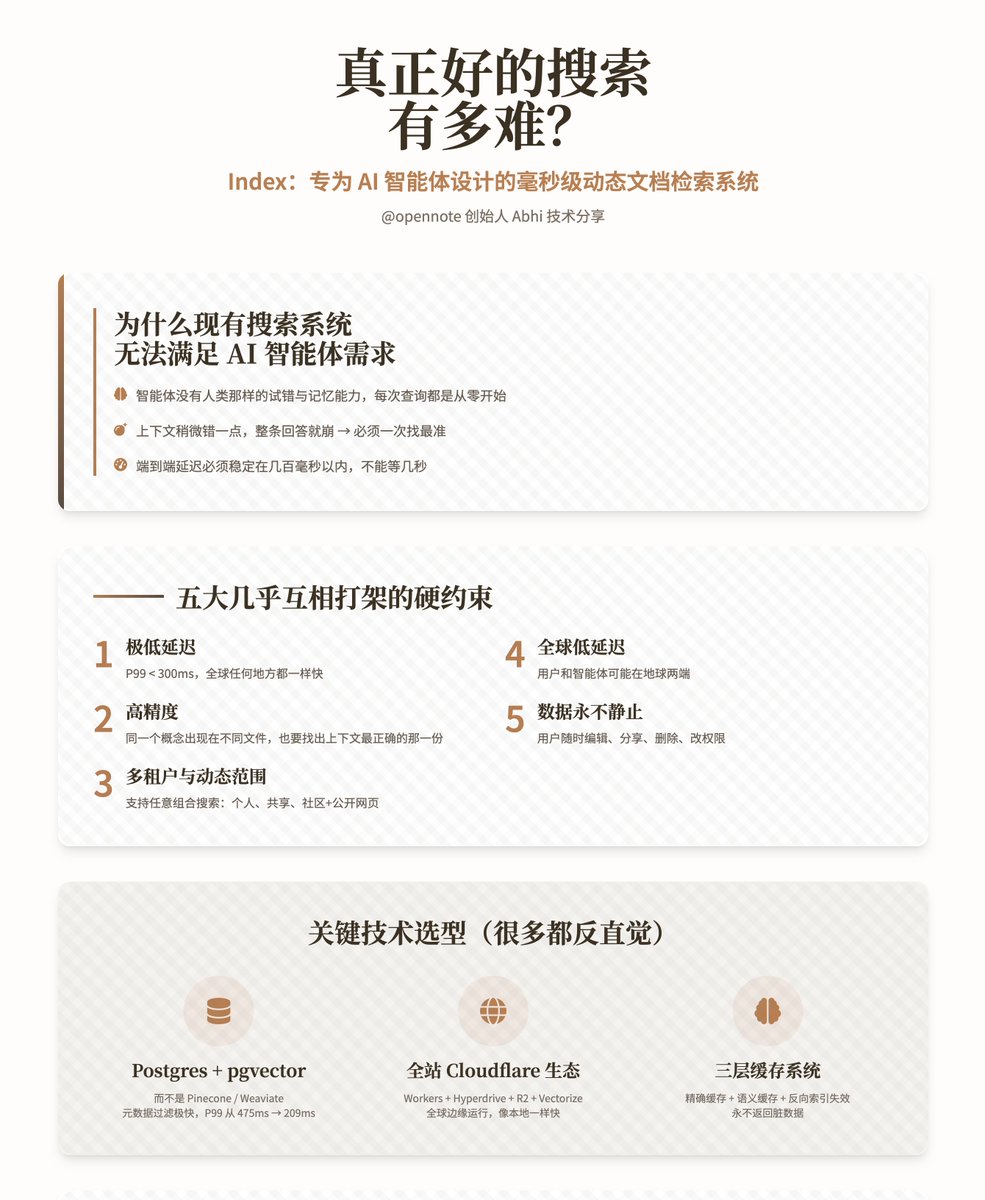
工程师们发布了支持代理和生产大型语言模型的检索、记忆和提示可移植性的工具和指南。- 索引:Opennote的毫秒级动态文档检索使用Postgres+pgvector、全球边缘运行时和缓存;P99 <300ms,令牌召回与向量数据库相当。- Memori:开放的SQL原生内存引擎提供持久、可查询的内存,具有自动提取、意识/自动模式和与多种大型语言模型的一行集成。- PromptBridge:通过校准配对提示映射并学习翻译映射而无需重新训练模型,迁移模型间的提示的框架。- 提示缓存:PagedAttention技术实现了用户间的全局KV缓存重用,在前缀稳定时将预填充计算减少到最多10倍,并降低首个令牌延迟。- 提示工程笔记:翻译者建议多步骤翻译+校对流程,以避免在长文档上出现幻觉和输出疲劳。- Smart Turn v3.1及其他开放项目改善了语音转接检测和边缘字幕;Hugging Face发布了《大型语言模型评估指南》,以标准化评估实践。
Key insights
索引显示生产检索优先考虑延迟、元数据过滤和动态更新
Opennote的索引引擎针对具有严格延迟和精度约束的代理用例进行了优化:它使用Postgres(pgvector+pg_trgm+tsvector)进行元数据过滤,运行在Cloudflare全球边缘,并实现了三级缓存和块哈希,以保持P99低于300ms。设计选择更倾向于快速、准确地检索小到中型文档集,并在动态权限管理方面优于现成的向量数据库。
Memori提供SQL原生、可审计的内存,具有多模式操作
Memori是一个开放的SQL原生内存引擎,能够与多种大型语言模型集成,提供持久、可查询的记忆。它提取实体,维持意识和自动模式,定期进行背景蒸馏,并通过单个API调用支持简单集成。该项目强调可审计存储,并利用SQL特性进行过滤和动态更新。
PromptBridge减少切换模型时的迁移成本
PromptBridge引入了一个校准步骤,以收集两个模型之间的配对最佳提示,并学习一个映射,将提示从源模型翻译到目标模型,而无需重新训练大型语言模型。这种方法在不同提供者之间迁移应用时,最小化了手动提示再工程的需求,并针对多代理和单代理场景进行了评估。
使用PagedAttention的提示缓存解锁了大规模推理成本的降低
基于PagedAttention的提示缓存利用基于内容的哈希KV块,实现用户间的全局缓存重用。最佳实践包括稳定前缀、确定性序列化和仅附加历史记录。合理使用时,缓存将预填充计算减少到最多10倍,并在高并发场景中显著降低首个令牌延迟。
社区资源和评估标准正在成熟
Hugging Face发布了《大型语言模型评估指南》,综合了三年和超过15,000个模型的数据,以帮助从业者避免基准陷阱。像Smart Turn v3.1这样的开放项目改善了语音转接检测和本地字幕,展示了多模态实时用例的工具进展。